Langflow 사용 가이드
Agent Builder와 함께 AI 사용자에서 AI 개발/설계자로 거듭나기
Langflow User Guide
From AI User to Developer/Architect with the Agent Builder
Langflow 使用指南
借助 Agent Builder,从 AI 使用者蜕变为开发者/设计者
Langflow 利用ガイド
Agent Builder と共に AI ユーザーから開発者/設計者へ
폐쇄망(Air-gapped) 환경 가이드
Air-gapped Environment Guide
封闭网络环境指南
閉域網環境ガイド
본 가이드는 폐쇄망(Air-gapped) 환경 기준입니다. 외부 클라우드 API(OpenAI, Anthropic 등)는 사용할 수 없으며, 사내 Private Cloud의 vLLM 기반 API를 OpenAI Compatible 컴포넌트로 연동합니다.
This guide targets air-gapped environments. External cloud APIs (OpenAI, Anthropic, etc.) are unavailable. We use OpenAI Compatible components to connect to vLLM APIs on our internal private cloud.
本指南针对封闭网络环境。外部云API不可用,使用 OpenAI Compatible 组件连接内部私有云的 vLLM API。
本ガイドは閉域網環境を対象としています。外部クラウドAPI(OpenAI、Anthropicなど)は利用できないため、社内プライベートクラウドの vLLM ベース API を OpenAI Compatible コンポーネントで連携します。
1. LLM & AI Agent 기본 이론
LLM (Large Language Model)이란?
LLM은 대규모 언어 모델의 약자로, 방대한 텍스트 데이터를 학습하여 자연어를 이해하고 생성하는 AI 모델입니다. 2017년 Google이 발표한 "Attention Is All You Need" 논문에서 제안된 Transformer 아키텍처를 기반으로 하며, GPT, Claude, Gemini, LLaMA 등이 대표적입니다.
LLM의 핵심 특징
- 텍스트 생성: 프롬프트에 대해 자연스러운 텍스트를 생성
- 문맥 이해: 긴 문맥을 파악하여 적절한 응답 생성
- 다양한 작업: 번역, 요약, 코드 생성, 질의응답 등
- 제한점: 학습 데이터 기반으로만 응답하며, 외부 시스템과의 상호작용은 자체적으로 불가능
AI Agent란?
AI Agent는 LLM + Tool + Skill + 자율적 추론/행동 루프를 결합한 시스템입니다. 단순 텍스트 생성을 넘어, 스스로 판단하고 외부 도구를 호출하여 실제 작업을 수행합니다.
AI Agent 생태계의 4가지 확장 개념
Tool (도구)
AI 시스템과 함께 사용하는 독립적인 외부 기능입니다. Agent가 직접 호출하여 LLM 자체로는 할 수 없는 작업을 수행합니다.
- Calculator: 수학 연산 수행
- Python REPL: Python 코드 실행
- API Request: 외부/내부 API 호출
- DB Query: 데이터베이스 검색
Agent는 사용자 요청을 분석한 후, 어떤 Tool을 사용할지 스스로 판단하여 호출합니다.
Skill (지식/지침)
AI 시스템이 특정 작업 시 자동으로 참조하는 지식 파일입니다. 코드 실행 없이 AI의 지식만 확장합니다.
- 예: "프론트엔드 디자인" Skill을 추가하면, UI 생성 요청 시 AI가 디자인 원칙을 자동 참조
- 설치가 간단하고, AI의 판단 기준과 전문 지식을 넓히는 역할
Plugin (확장 패키지)
명령어, 훅, 동작을 하나의 패키지로 묶은 확장입니다. AI 시스템의 행동 자체를 확장합니다.
- 예: 개발 워크플로 Plugin을 설치하면 TDD, 코드 리뷰, 체계적 디버깅 등 전문 워크플로 제공
- 마켓플레이스에서 설치하며, 여러 Skill + Tool을 번들로 제공
MCP (Model Context Protocol)
AI가 외부 서비스(DB, API, SaaS)에 직접 접근할 수 있게 해주는 프로토콜입니다.
- 예: Notion MCP를 설정하면 AI가 Notion 워크스페이스의 문서를 검색/업데이트
- 외부 서비스 연동에 API 키나 인증 정보가 필요할 수 있음
요약
Tool = Agent가 호출하는 독립 기능 | Skill = AI가 참조하는 지식 파일 | Plugin = 여러 기능을 묶은 확장 패키지 | MCP = 외부 서비스 연결 프로토콜
1. LLM & AI Agent Fundamentals
What is an LLM?
LLM stands for Large Language Model — an AI model trained on vast text data to understand and generate natural language. Based on the Transformer architecture from Google's "Attention Is All You Need" paper (2017). Examples: GPT, Claude, Gemini, LLaMA.
Key Characteristics
- Text Generation: Generates natural text from prompts
- Context Understanding: Comprehends long contexts for relevant responses
- Versatile Tasks: Translation, summarization, code generation, Q&A
- Limitations: Responds only from training data; cannot interact with external systems alone
What is an AI Agent?
An AI Agent combines LLM + Tools + Skills + an autonomous reasoning/action loop. Beyond text generation, it autonomously decides and invokes external tools to perform real tasks.
4 Extension Concepts in the AI Agent Ecosystem
Tool
Independent external functions used alongside the AI system. The Agent invokes them to perform tasks the LLM can't do on its own.
- Calculator: Math operations
- Python REPL: Code execution
- API Request: External/internal API calls
- DB Query: Database search
The Agent analyzes the request and autonomously decides which Tool to use.
Skill (Knowledge/Instructions)
Knowledge files the AI automatically references during specific tasks. Extends the AI's knowledge without code execution.
- Example: Adding a "Frontend Design" Skill makes the AI auto-reference design principles when generating UI
- Easy to install; expands the AI's judgment criteria and expertise
Plugin (Extension Package)
Bundled packages of commands, hooks, and behaviors that extend the AI system's actions.
- Example: A dev workflow Plugin provides TDD, code review, systematic debugging workflows
- Installed from marketplaces; bundles multiple Skills + Tools together
MCP (Model Context Protocol)
A protocol enabling the AI to directly access external services (databases, APIs, SaaS).
- Example: Setting up Notion MCP lets the AI search and update Notion workspace documents
- May require API keys or authentication for external service integration
Summary
Tool = Independent functions the Agent calls | Skill = Knowledge files the AI references | Plugin = Bundled extension packages | MCP = External service connection protocol
1. LLM 与 AI Agent 基础理论
什么是 LLM?
LLM 即大型语言模型,通过学习海量文本数据来理解和生成自然语言。基于 Google 2017 年发表的 "Attention Is All You Need" 论文提出的 Transformer 架构。代表模型:GPT、Claude、Gemini、LLaMA。
核心特点
- 文本生成:根据提示词生成自然文本
- 上下文理解:理解长文本上下文生成恰当回复
- 多种任务:翻译、摘要、代码生成、问答等
- 局限性:仅基于训练数据回复,无法自主与外部系统交互
什么是 AI Agent?
AI Agent 结合了 LLM + 工具(Tool)+ 技能(Skill)+ 自主推理/行动循环。超越简单文本生成,能自主判断并调用外部工具执行实际任务。
AI Agent 生态系统的 4 个扩展概念
Tool(工具)
与 AI 系统配合使用的独立外部功能。Agent 调用它们执行 LLM 自身无法完成的任务。
- Calculator:数学运算
- Python REPL:代码执行
- API Request:调用外部/内部 API
- DB Query:数据库检索
Skill(知识/指令)
AI 在特定任务中自动参考的知识文件。无需代码执行即可扩展 AI 的知识。
- 示例:添加"前端设计"Skill 后,AI 在生成 UI 时自动参考设计原则
- 安装简单;扩展 AI 的判断标准和专业知识
Plugin(扩展包)
将命令、钩子、行为打包为一个扩展。扩展 AI 系统的行为本身。
- 示例:开发工作流 Plugin 提供 TDD、代码审查、系统化调试等工作流
- 从市场安装;捆绑多个 Skill + Tool
MCP(Model Context Protocol)
使 AI 能直接访问外部服务(数据库、API、SaaS)的协议。
- 示例:设置 Notion MCP 后,AI 可搜索和更新 Notion 工作区文档
- 可能需要 API 密钥或认证信息
总结
Tool = Agent 调用的独立功能 | Skill = AI 参考的知识文件 | Plugin = 捆绑的扩展包 | MCP = 外部服务连接协议
1. LLM & AI Agent 基礎理論
LLM(大規模言語モデル)とは?
LLMは大規模言語モデルの略で、膨大なテキストデータを学習して自然言語を理解・生成するAIモデルです。2017年にGoogleが発表した "Attention Is All You Need" 論文で提案されたTransformerアーキテクチャを基盤としており、GPT、Claude、Gemini、LLaMAなどが代表例です。
LLMの主な特徴
- テキスト生成:プロンプトに対して自然なテキストを生成
- 文脈理解:長い文脈を把握して適切な応答を生成
- 多様なタスク:翻訳、要約、コード生成、質問応答など
- 制限:学習データに基づいてのみ回答し、外部システムとの連携は単体では不可能
AI Agentとは?
AI AgentはLLM + Tool + Skill + 自律的な推論・行動ループを組み合わせたシステムです。単純なテキスト生成を超え、自ら判断して外部ツールを呼び出し、実際のタスクを実行します。
AI Agentエコシステムの4つの拡張概念
Tool(ツール)
AIシステムと組み合わせて使う独立した外部機能です。AgentがLLM単体では実行できないタスクを行うために呼び出します。
- Calculator:数学演算の実行
- Python REPL:Pythonコードの実行
- API Request:外部・内部APIの呼び出し
- DB Query:データベース検索
Agentはユーザーのリクエストを分析した後、どのToolを使うかを自律的に判断して呼び出します。
Skill(知識・指示)
AIシステムが特定のタスク時に自動的に参照する知識ファイルです。コード実行なしにAIの知識だけを拡張します。
- 例:「フロントエンドデザイン」SkillをAIに追加すると、UI生成のリクエスト時にデザイン原則を自動参照
- 導入が簡単で、AIの判断基準と専門知識を広げる役割を担う
Plugin(拡張パッケージ)
コマンド、フック、動作をひとつのパッケージにまとめた拡張です。AIシステムの行動そのものを拡張します。
- 例:開発ワークフローPluginを導入すると、TDD・コードレビュー・体系的なデバッグなどの専門ワークフローを提供
- マーケットプレイスからインストールし、複数のSkill + Toolをバンドルとして提供
MCP(Model Context Protocol)
AIが外部サービス(DB、API、SaaS)に直接アクセスできるようにするプロトコルです。
- 例:Notion MCPを設定すると、AIがNotionワークスペースのドキュメントを検索・更新
- 外部サービス連携にAPIキーや認証情報が必要な場合あり
まとめ
Tool = Agentが呼び出す独立機能 | Skill = AIが参照する知識ファイル | Plugin = 複数機能をまとめた拡張パッケージ | MCP = 外部サービス接続プロトコル
AI Agent 아키텍처AI Agent ArchitectureAI Agent 架构AI Agent アーキテクチャ
Token: 반도체의 Memory처럼, AI의 기본 단위
반도체에서 Memory(메모리)가 데이터를 저장하는 기본 단위라면, LLM에서 Token은 언어를 처리하는 기본 단위입니다. 한 단어가 1~3개의 토큰으로 분해되며, 모든 비용과 성능이 토큰 수로 결정됩니다.
- 비용: API 과금 단위 = 토큰 수 (입력 + 출력)
- 속도: 토큰이 많을수록 처리 시간 증가
- Context Window: 모델이 한 번에 처리할 수 있는 최대 토큰 수 (예: 128K, 200K, 1M)
Tokenomics: Token이 경제의 새로운 단위가 되다
NVIDIA CEO Jensen Huang은 GTC 2026에서 "AI Factory" 개념을 발표하며, 데이터센터를 전기와 데이터를 원료로 토큰(지능의 단위)을 생산하는 공장으로 재정의했습니다. 그가 제시한 공식은 다음과 같습니다:
Revenue = Tokens per Watt × Available Gigawatts
이 공식은 에너지 효율(Tokens per Watt)이 곧 매출로 직결됨을 의미합니다. 1GW급 AI Factory 하나가 약 1,000억 달러의 건설 비용에 연간 1,500억 달러의 토큰 매출을 올릴 것으로 전망됩니다.
Huang은 "제1차 산업혁명은 전기를 생산했고, 제2차 산업혁명은 AI Factory를 통해 지능을 생산한다"고 선언했습니다. 토큰은 이제 석유나 전기처럼 측정·거래 가능한 경제적 산출물이 되었으며, 이를 Tokenomics(토큰 경제학)라 부릅니다.
KV-Cache: 토큰 생성의 핵심 메커니즘
토큰을 효율적으로 생산하려면 KV-Cache(Key-Value Cache)에 대한 이해가 필수입니다. CPU에 L1/L2 캐시가 있듯이, LLM에는 KV-Cache가 있습니다.
Transformer의 Attention 연산에서 새로운 토큰을 생성할 때마다, 이전에 처리한 모든 토큰의 Key와 Value 벡터를 다시 계산해야 합니다. KV-Cache는 이미 계산된 K, V를 GPU 메모리에 저장해두어 재계산을 생략함으로써 추론 속도를 획기적으로 높입니다.
GPU VRAM 할당 구조
GPU에 모델을 올리면 VRAM은 크게 두 영역으로 나뉩니다: 모델 가중치(Weights)가 고정 영역을 차지하고, 나머지 VRAM이 KV-Cache로 사용됩니다. 즉, 남는 VRAM이 클수록 더 많은 요청을 동시에 처리할 수 있습니다. 예를 들어 70B 모델이 8K 컨텍스트를 처리할 때 요청 1건당 KV-Cache가 약 20GB를 차지하므로, 남은 VRAM의 크기가 곧 동시 처리 성능을 결정합니다.
왜 단편화가 발생했나? (PagedAttention 이전)
기존 방식에서는 KV-Cache를 연속 메모리(contiguous allocation)로 할당했습니다. 요청이 들어올 때 출력 길이를 미리 알 수 없으므로, 최대 가능한 컨텍스트 길이(예: 2048토큰)만큼 VRAM을 미리 예약합니다. 실제로는 100토큰만 생성하고 끝나더라도 나머지 1948토큰분 메모리는 잠긴 채 낭비됩니다.
요청마다 다른 시점에 종료되면서 중간중간 빈 구멍이 생기지만, 이 구멍들은 연속 공간이 아니라 새 요청에 할당할 수 없습니다. 이것이 OS의 외부 단편화(External Fragmentation)와 동일한 문제이며, GPU 메모리의 60~80%가 이렇게 낭비되었습니다.
PagedAttention: OS 가상 메모리에서 영감을 얻은 해법
OS가 외부 단편화를 페이징(Paging)으로 해결했듯, vLLM의 PagedAttention(Woosuk Kwon et al., 2023)은 KV-Cache를 고정 크기 블록(기본 16토큰)으로 나누어, 토큰이 생성될 때마다 필요한 만큼만 동적 할당합니다. 블록들이 물리적으로 연속일 필요가 없으므로 단편화가 사라집니다.
- 메모리 낭비 60~80% → 4% 미만으로 절감
- 동일 GPU에서 처리량(throughput) 2~4배 향상
- 공통 프롬프트 프리픽스의 KV-Cache를 여러 요청이 공유(Automatic Prefix Caching)
VRAM이 부족하면? — OS Page Fault와 같은 원리
사용자가 너무 많아 KV-Cache용 VRAM이 가득 차면, OS에서 Page Fault가 발생하는 것과 동일한 상황이 벌어집니다. vLLM은 이를 계층적 캐시(Hierarchical Cache)로 처리합니다:
- GPU VRAM 가득 참 → 우선순위 낮은 요청의 KV-Cache를 CPU 메모리로 스왑(eviction)
- CPU도 부족 → 디스크로 스왑
- 그래도 부족 → 요청을 큐에 대기(waiting)시키거나 선점(preemption)
OS에서 Page Fault가 너무 잦으면 스래싱(Thrashing)이 발생하듯, KV-Cache 스왑이 빈번하면 추론 성능이 급격히 저하됩니다. 이것이 프로덕션 환경에서 GPU 수와 VRAM 크기가 중요한 근본적인 이유입니다.
후술할 Section 3의 vLLM 컴포넌트가 바로 이 PagedAttention 기반 추론 엔진을 Langflow에서 사용하는 방법입니다.

하지만 나날이 증가하는 사용자와 그들이 소비하는 막대한 토큰량에 비해 GPU 수가 한정적이라면, PagedAttention과 KV-Cache 최적화도 무색하게 추론 성능과 속도가 급격히 떨어집니다. 결국 충분한 GPU 인프라 확보가 안정적인 서비스의 전제 조건입니다.
However, if the number of GPUs is limited relative to ever-growing users and their massive token consumption, even PagedAttention and KV-Cache optimizations become insufficient — inference performance and speed degrade sharply. Ultimately, securing adequate GPU infrastructure is the prerequisite for stable service.
然而,如果相对于不断增长的用户及其海量 Token 消耗,GPU 数量有限,即使 PagedAttention 和 KV-Cache 优化也无济于事——推理性能和速度会急剧下降。最终,确保充足的 GPU 基础设施是稳定服务的前提。
しかし、増え続けるユーザーと膨大なToken消費量に対してGPU数が限られている場合、PagedAttentionやKV-Cache最適化も及ばず、推論性能と速度は急激に低下します。結局、十分なGPUインフラの確保が安定サービスの前提条件です。
Token: Like Memory in Semiconductors, the Basic Unit of AI
Just as Memory is the basic unit of data storage in semiconductors, Tokens are the basic unit of language processing in LLMs. A single word breaks down into 1-3 tokens, and all costs and performance are determined by token count.
- Cost: API billing unit = token count (input + output)
- Speed: More tokens = more processing time
- Context Window: Maximum tokens a model can process at once (e.g., 128K, 200K, 1M)
Tokenomics: Tokens as a New Economic Unit
At GTC 2026, NVIDIA CEO Jensen Huang introduced the "AI Factory" concept — redefining data centers as factories that convert electricity and data into tokens (units of intelligence). His formula:
Revenue = Tokens per Watt × Available Gigawatts
Energy efficiency (Tokens per Watt) directly translates to revenue. A 1GW AI Factory costs ~$100B to build and is projected to generate $150B in annual token revenue.
Huang declared: "The first industrial revolution produced electricity; the second, with AI Factories, produces intelligence." Tokens have become a measurable, tradeable economic output like oil or electricity — a concept known as Tokenomics.
KV-Cache: The Core Mechanism of Token Generation
Efficient token production requires understanding KV-Cache (Key-Value Cache). Just as CPUs have L1/L2 cache, LLMs have KV-Cache.
Each time the Transformer generates a new token, it needs all previously computed Key and Value vectors. KV-Cache stores these in GPU memory, skipping recomputation and dramatically accelerating inference.
GPU VRAM Allocation
When a model is loaded onto a GPU, VRAM splits into two regions: model weights occupy a fixed portion, and the remaining VRAM is used for KV-Cache. More leftover VRAM = more concurrent requests. A 70B model with 8K context uses ~20GB of KV-Cache per request, so available VRAM directly determines concurrent throughput.
Why Did Fragmentation Occur? (Before PagedAttention)
Traditional systems allocated KV-Cache as contiguous memory. Since output length is unknown at request time, the system pre-reserves the maximum context length (e.g., 2048 tokens). If only 100 tokens are actually generated, the remaining 1948 tokens' worth of memory stays locked and wasted.
As requests finish at different times, gaps appear — but these gaps aren't contiguous, so new requests can't use them. This is exactly external fragmentation, just like in OS memory management, wasting 60-80% of GPU memory.
PagedAttention: Inspired by OS Virtual Memory
Just as OS solved external fragmentation with paging, vLLM's PagedAttention (Woosuk Kwon et al., 2023) splits KV-Cache into fixed-size blocks (default 16 tokens), dynamically allocated as tokens are generated. Blocks don't need to be physically contiguous, eliminating fragmentation.
- Memory waste reduced from 60-80% to under 4%
- 2-4x throughput improvement on the same GPU
- Automatic Prefix Caching: shared KV-Cache across requests with common prefixes
What if VRAM Runs Out? — Same Principle as OS Page Faults
When too many concurrent users exhaust KV-Cache VRAM, it's analogous to OS page faults. vLLM handles this with hierarchical caching:
- GPU VRAM full → evict lower-priority requests' KV-Cache to CPU memory
- CPU full → swap to disk
- Still full → queue requests or preempt
Just as excessive page faults cause thrashing in an OS, frequent KV-Cache swaps degrade inference performance sharply. This is the fundamental reason GPU count and VRAM size matter in production deployments.
The vLLM components in Section 3 are how you use this PagedAttention-powered inference engine within Langflow.
Token:如同半导体中的 Memory,AI 的基本单位
正如Memory是半导体中数据存储的基本单位,Token是 LLM 处理语言的基本单位。一个单词分解为 1-3 个 Token,所有成本和性能都由 Token 数量决定。
- 成本:API 计费单位 = Token 数量(输入 + 输出)
- 速度:Token 越多,处理时间越长
- 上下文窗口:模型一次可处理的最大 Token 数(如 128K、200K、1M)
Tokenomics:Token 成为新的经济单位
NVIDIA CEO Jensen Huang 在 GTC 2026 上提出 "AI Factory" 概念——将数据中心重新定义为以电力和数据为原料、生产Token(智能单位)的工厂。其公式:Revenue = Tokens per Watt × Available Gigawatts。1GW 级 AI Factory 建设成本约 1000 亿美元,预计年产 Token 收入 1500 亿美元。Token 已成为如石油、电力一般可衡量、可交易的经济产出。
KV-Cache:Token 生成的核心机制
高效生产 Token 需要理解 KV-Cache。Transformer 每生成一个新 Token,都需要之前所有 Token 的 Key 和 Value 向量。KV-Cache 将其存储在 GPU 内存中,跳过重新计算。GPU 加载模型后,剩余 VRAM 即用于 KV-Cache——剩余越多,可并发处理的请求越多。70B 模型处理 8K 上下文时,每请求约 20GB。
为什么会产生碎片化?(PagedAttention 之前)
传统方式将 KV-Cache 分配为连续内存。由于无法预知输出长度,系统会预留最大上下文长度(如 2048 Token)。实际只生成 100 Token,其余内存仍被锁定浪费。请求在不同时间结束,产生不连续的空隙——这正是 OS 的外部碎片化,浪费了 60-80% GPU 内存。
PagedAttention:受 OS 虚拟内存启发的解决方案
如同 OS 用分页(Paging)解决碎片化,PagedAttention(Woosuk Kwon 等,2023)将 KV-Cache 拆分为固定大小块(默认 16 Token),按需动态分配,块无需物理连续。内存浪费从 60-80% 降至 4% 以下,吞吐量提升 2-4 倍。
VRAM 不足时?——与 OS Page Fault 相同的原理
并发用户过多耗尽 VRAM 时,vLLM 通过分层缓存处理:GPU VRAM 满 → 换出到 CPU 内存 → 换出到磁盘 → 排队等待。如同 OS 中频繁 Page Fault 导致抖动(Thrashing),KV-Cache 频繁换出会使推理性能急剧下降。这就是生产环境中 GPU 数量和 VRAM 大小至关重要的根本原因。
后文 Section 3 的 vLLM 组件正是在 Langflow 中使用这一 PagedAttention 推理引擎的方式。
Token:半導体のMemoryのように、AIの基本単位
半導体でMemoryがデータ保存の基本単位であるように、LLMではTokenが言語処理の基本単位です。1つの単語が1〜3個のTokenに分解され、すべてのコストとパフォーマンスがToken数で決まります。
- コスト:API課金単位 = Token数(入力 + 出力)
- 速度:Tokenが多いほど処理時間が増加
- Context Window:モデルが一度に処理できる最大Token数(例:128K、200K、1M)
Tokenomics:Tokenが経済の新たな単位に
NVIDIA CEO Jensen HuangはGTC 2026で「AI Factory」構想を発表し、データセンターを電力とデータからToken(知能の単位)を生産する工場として再定義しました。公式:Revenue = Tokens per Watt × Available Gigawatts。1GW級AI Factoryは建設費約1,000億ドル、年間Token売上1,500億ドルを見込みます。Tokenは石油や電気のような測定・取引可能な経済的産出物となりました。
KV-Cache:Token生成の核心メカニズム
効率的なToken生産にはKV-Cacheの理解が必須です。Transformerは新しいTokenを生成するたびに、それまでのすべてのTokenのKeyとValueベクトルが必要です。KV-Cacheはこれらをメモリに保存し再計算をスキップします。GPUにモデルを読み込むと、残りのVRAMがKV-Cacheに使われ、残りが多いほど同時処理できるリクエストが増えます。70Bモデルで8Kコンテキストの場合、リクエスト1件あたり約20GBが必要です。
なぜフラグメンテーションが発生したのか?(PagedAttention以前)
従来方式ではKV-Cacheを連続メモリで割り当てていました。出力長が事前に分からないため、最大コンテキスト長(例:2048トークン)分のVRAMを予約します。実際に100トークンしか生成しなくても残りは無駄になります。リクエストが異なるタイミングで終了し、不連続な隙間が生まれますが、連続空間ではないため新しいリクエストに使えません。これはOSの外部フラグメンテーションと同じ問題で、GPUメモリの60〜80%が浪費されていました。
PagedAttention:OS仮想メモリに着想を得た解決策
OSがページングで外部フラグメンテーションを解決したように、PagedAttention(Woosuk Kwonら、2023)はKV-Cacheを固定サイズブロック(デフォルト16トークン)に分割し、トークン生成時に必要な分だけ動的割当てします。ブロックが物理的に連続である必要がないため、フラグメンテーションが解消されます。メモリ浪費60〜80%→4%未満、スループット2〜4倍向上。
VRAMが不足したら?——OS Page Faultと同じ原理
同時ユーザーが多すぎてKV-Cache用VRAMが枯渇すると、OSのPage Faultと同様の状況が発生します。vLLMは階層キャッシュで対処します:GPU VRAM満杯→CPUメモリへスワップ→ディスクへスワップ→キュー待ち。OSで頻繁なPage Faultがスラッシングを引き起こすように、KV-Cacheの頻繁なスワップは推論性能を急激に低下させます。これが本番環境でGPU数とVRAMサイズが重要な根本的理由です。
後述のSection 3のvLLMコンポーネントが、このPagedAttentionベースの推論エンジンをLangflowで使用する方法です。
주요 모델 프로바이더 (2026.08 기준)
Major Model Providers (as of Aug 2026)
主要模型提供商(截至2026年8月)
主要モデルプロバイダー(2026年8月時点)
| 프로바이더 | Provider | 提供商 | プロバイダー | 최신 모델 | Latest Models | 最新模型 | 最新モデル | 파라미터 | Params | 参数 | パラメータ | Context | GPU 추론 | GPU Inference | GPU 推理 | GPU推論 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| OpenAI | OpenAI | OpenAI | OpenAI | GPT-5.6 (Sol/Terra/Luna) | GPT-5.6 (Sol/Terra/Luna) | GPT-5.6 (Sol/Terra/Luna) | GPT-5.6 (Sol/Terra/Luna) | 비공개 (MoE) | Undisclosed (MoE) | 未公开 (MoE) | 非公開 (MoE) | 1M | API 전용 | API only | 仅 API | APIのみ |
| Anthropic | Anthropic | Anthropic | Anthropic | Claude Opus 5, Fable 5 | Claude Opus 5, Fable 5 | Claude Opus 5, Fable 5 | Claude Opus 5, Fable 5 | 비공개 | Undisclosed | 未公开 | 非公開 | 1M | API 전용 | API only | 仅 API | APIのみ |
| Gemini 3.1 Pro, 3.7 Flash | Gemini 3.1 Pro, 3.7 Flash | Gemini 3.1 Pro, 3.7 Flash | Gemini 3.1 Pro, 3.7 Flash | 비공개 | Undisclosed | 未公开 | 非公開 | 2M | API 전용 | API only | 仅 API | APIのみ | ||||
| Meta (OSS) | Meta (OSS) | Meta (OSS) | Meta (OSS) | Llama 4 Scout/Maverick | Llama 4 Scout/Maverick | Llama 4 Scout/Maverick | Llama 4 Scout/Maverick | 109B/402B (17B/40B active) | 10M | Scout 1x H100, Maverick 4x H100 (INT4) | Scout 1x H100, Maverick 4x H100 (INT4) | Scout 1x H100, Maverick 4x H100 (INT4) | Scout 1x H100, Maverick 4x H100 (INT4) | |||
| Qwen (OSS) | Qwen (OSS) | Qwen (OSS) | Qwen (OSS) | Qwen3.8-Max / 3.8-27B | Qwen3.8-Max / 3.8-27B | Qwen3.8-Max / 3.8-27B | Qwen3.8-Max / 3.8-27B | 2.4T (95B active) / 27B | 262K | Max: 8x H200 (FP8) · 27B: 24GB 1장 | Max: 8x H200 (FP8) · 27B: single 24GB | Max: 8x H200 (FP8) · 27B: 单张 24GB | Max: 8x H200 (FP8) · 27B: 24GB 1枚 | |||
| GLM (OSS) | GLM (OSS) | GLM (OSS) | GLM (OSS) | GLM-5.2 (5.3은 가중치 미공개) | GLM-5.2 (5.3 weights unreleased) | GLM-5.2 (5.3 权重未公开) | GLM-5.2 (5.3 は重み未公開) | 753B (~40B active) | 1M | 8x H200 (FP8), BF16은 16x H100 | 8x H200 (FP8); BF16 needs 16x H100 | 8x H200 (FP8), BF16 需 16x H100 | 8x H200 (FP8), BF16 は 16x H100 | |||
| Kimi (OSS) | Kimi (OSS) | Kimi (OSS) | Kimi (OSS) | Kimi K3 | Kimi K3 | Kimi K3 | Kimi K3 | 2.8T (~50B active) | 1M | MXFP4 기준 가중치 ~1.4TB — 서버급 필수 | ~1.4TB weights at MXFP4 — datacenter-class only | MXFP4 权重约 1.4TB — 需数据中心级 | MXFP4 で重み約1.4TB — サーバー級必須 |
폐쇄망(Air-gapped)에서의 선택
폐쇄망에서는 가중치가 공개된 모델(Llama 4, Qwen3.8, GLM-5.2, Kimi K3 등)을 vLLM으로 호스팅합니다. OpenAI Compatible로 동일하게 연동됩니다.
"최신 = 사용 가능"이 아닙니다. API로 먼저 공개되고 가중치는 나중에 풀리거나 아예 안 풀리는 경우가 많습니다. 예를 들어 GLM-5.3은 2026년 8월 14일 발표됐지만 가중치가 공개되지 않아 폐쇄망에서는 쓸 수 없고, 자체 호스팅 대상은 여전히 GLM-5.2입니다. 모델을 고를 때는 발표 시점이 아니라 가중치 공개 여부와 라이선스를 먼저 확인하세요.
규모도 현실적으로 보셔야 합니다. Kimi K3는 MXFP4로도 가중치가 약 1.4TB라 데이터센터급 장비가 필요한 반면, Qwen3.8-27B는 4bit 양자화 시 24GB GPU 한 장에 올라갑니다. 사내 GPU 예산에 맞춰 고르세요.
Air-gapped Choice
Air-gapped, you host models whose weights are published (Llama 4, Qwen3.8, GLM-5.2, Kimi K3, …) on vLLM, wired up through OpenAI Compatible as usual.
"Newest" does not mean "available." Models often ship on API first, with weights following later — or never. GLM-5.3 launched on 14 Aug 2026, but its weights are unpublished, so it cannot be used air-gapped; GLM-5.2 remains the self-hostable option. Check weight availability and licence before announcement date.
Be realistic about size, too. Kimi K3 is ~1.4TB of weights even at MXFP4 — datacenter hardware — whereas Qwen3.8-27B fits on a single 24GB GPU when 4-bit quantized. Pick against your actual GPU budget.
封闭网络中的选择
封闭网络中使用 vLLM 托管已公开权重的模型(Llama 4、Qwen3.8、GLM-5.2、Kimi K3 等),同样通过 OpenAI Compatible 集成。
"最新"不等于"可用"。模型常先开放 API,权重稍后公开甚至始终不公开。例如 GLM-5.3 于 2026 年 8 月 14 日发布,但权重未公开,封闭网络无法使用,可自托管的仍是 GLM-5.2。选型时请先确认权重是否公开及许可证,而非发布时间。
规模也需现实考量。Kimi K3 即便采用 MXFP4,权重仍约 1.4TB,需数据中心级设备;而 Qwen3.8-27B 经 4bit 量化后可装入单张 24GB GPU。请按实际 GPU 预算选择。
閉域網での選択
閉域網では重みが公開されたモデル(Llama 4、Qwen3.8、GLM-5.2、Kimi K3 など)を vLLM でホスティングし、OpenAI Compatible で同様に連携します。
「最新=使える」ではありません。API が先行公開され、重みは後から、あるいは公開されないことも多々あります。例えば GLM-5.3 は2026年8月14日に発表されましたが、重みが未公開のため閉域網では使用できず、自己ホスティング対象は依然 GLM-5.2 です。選定時は発表時期ではなく重みの公開有無とライセンスを先に確認してください。
規模も現実的に見る必要があります。Kimi K3 は MXFP4 でも重みが約1.4TB でデータセンター級の設備が必要な一方、Qwen3.8-27B は4bit量子化で24GB GPU 1枚に載ります。社内 GPU 予算に合わせて選んでください。
퀴즈
Quiz
测验
クイズ
AI Agent와 LLM의 가장 큰 차이점은 무엇인가요?
What is the biggest difference between an AI Agent and an LLM?
AI Agent 与 LLM 最大的区别是什么?
AI AgentとLLMの最も大きな違いは何ですか?
정답 보기
Show Answer
查看答案
答えを見る
AI Agent는 LLM과 달리 외부 Tool을 자율적으로 호출하여 실제 작업을 수행할 수 있습니다. LLM은 텍스트 생성만 가능하지만, Agent는 추론 → Tool 호출 → 결과 분석의 루프를 반복합니다.
Unlike an LLM, an AI Agent can autonomously call external Tools to perform real tasks. An LLM can only generate text, whereas an Agent repeatedly loops through reasoning → Tool call → result analysis.
与LLM不同,AI Agent能够自主调用外部工具执行实际任务。LLM仅能生成文本,而Agent会反复循环执行推理→工具调用→结果分析的过程。
AI AgentはLLMとは異なり、外部ToolをAIが自律的に呼び出して実際の作業を行えます。LLMはテキスト生成のみ可能ですが、Agentは推論→Tool呼び出し→結果分析のループを繰り返します。
2. 왜 Langflow인가
Langflow는 비주얼 드래그 앤 드롭으로 LLM 애플리케이션과 AI Agent를 구축할 수 있는 오픈소스 플랫폼입니다.
2. Why Langflow?
Langflow is an open-source platform for building LLM applications and AI Agents through visual drag-and-drop.
2. 为何选择 Langflow?
Langflow 是通过可视化拖拽构建 LLM 应用和 AI Agent 的开源平台。
2. なぜ Langflow か
Langflow はビジュアルなドラッグ&ドロップで LLM アプリケーションと AI Agent を構築できるオープンソースプラットフォームです。
비주얼 빌더
Visual Builder
可视化构建
ビジュアルビルダー
드래그 앤 드롭으로 AI 파이프라인을 시각적으로 구성. 코드 없이도 Flow를 만들 수 있습니다.
Build AI pipelines visually with drag-and-drop. Create Flows without writing code.
拖拽方式可视化构建 AI 管道,无需编写代码即可创建 Flow。
ドラッグ&ドロップで AI パイプラインをビジュアルに構成。コードなしで Flow を作成できます。
오픈소스
Open Source
开源
オープンソース
Apache 2.0 라이선스. 자유롭게 사용, 수정, 배포 가능. 폐쇄망(Air-gapped) 내 자체 호스팅이 가능합니다.
Apache 2.0 license. Free to use, modify, distribute. Self-hostable in air-gapped networks.
Apache 2.0 许可证。可自由使用、修改、分发。支持封闭网络内自托管。
Apache 2.0 ライセンス。自由に使用・修正・配布可能。閉域網内でのセルフホスティングも対応。
Python 확장성
Python Extensibility
Python 扩展性
Python 拡張性
Custom Component를 Python으로 작성하여 기존 라이브러리와 자유롭게 통합할 수 있습니다.
Write Custom Components in Python and freely integrate existing libraries.
使用 Python 编写自定义组件,自由集成现有库。
カスタムコンポーネントを Python で記述し、既存ライブラリと自由に統合できます。
OpenAI Compatible
OpenAI Compatible
OpenAI Compatible
OpenAI Compatible
사내 vLLM 등 OpenAI 호환 API를 제공하는 모델 서버와 바로 연동됩니다.
Connects directly to any OpenAI-compatible model server like internal vLLM.
可直接连接任何 OpenAI 兼容模型服务器(如内部 vLLM)。
社内 vLLM など OpenAI 互換 API を提供するモデルサーバーに直接連携できます。
Agent + Tool Mode
Agent + Tool Mode
Agent + 工具模式
Agent + Tool Mode
내장 Agent 컴포넌트와 Tool Mode로 자율 에이전트를 쉽게 구성할 수 있습니다.
Built-in Agent component and Tool Mode make it easy to build autonomous agents.
内置 Agent 组件和工具模式,轻松构建自主 Agent。
内蔵の Agent コンポーネントと Tool Mode で自律エージェントを簡単に構成できます。
API 자동 제공
Auto API Endpoint
自动提供 API
API 自動提供
만든 Flow를 OpenAI 호환 /responses API로 자동 노출. 다른 시스템에서 바로 호출 가능합니다.
Automatically exposes Flows as OpenAI-compatible /responses API for external systems.
自动将 Flow 暴露为 OpenAI 兼容 /responses API,可从外部系统直接调用。
作成した Flow を OpenAI 互換 /responses API として自動公開。他システムからすぐに呼び出せます。
다른 플랫폼과의 비교
AI 워크플로 빌더는 Langflow 외에도 여러 가지가 있습니다. 각 플랫폼의 특성을 비교하면 Langflow를 선택해야 하는 이유가 명확해집니다.
Comparison with Other Platforms
Several AI workflow builders exist beyond Langflow. Comparing their characteristics makes the case for Langflow clear.
与其他平台的比较
除 Langflow 外还有多种 AI 工作流构建工具。比较各平台特点可以明确选择 Langflow 的理由。
他プラットフォームとの比較
Langflow 以外にも AI ワークフロービルダーは複数あります。各プラットフォームの特性を比較すると、Langflow を選ぶ理由が明確になります。
| 비교 항목 | Feature | 比较项 | 比較項目 | Langflow | Dify | Flowise | n8n | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 핵심 강점 | Core Strength | 核心优势 | 核心強み | 복잡한 AI Agent Flow | Complex AI Agent Flows | 复杂 AI Agent Flow | 複雑な AI Agent Flow | 올인원 LLM 플랫폼 | All-in-one LLM platform | 一站式 LLM 平台 | オールインワンLLM | 빠른 RAG 챗봇 | Quick RAG chatbot | 快速 RAG 聊天机器人 | 高速RAGチャットボット | 범용 자동화 + AI | General automation + AI | 通用自动化 + AI | 汎用自動化+AI |
| 코드 커스터마이징 | Code Customization | 代码自定义 | コードカスタマイズ | Python 자유 작성 | Free Python authoring | 自由 Python 编写 | Python自由記述 | 샌드박스 제한 | Sandbox limited | 沙盒限制 | サンドボックス制限 | 제한적 | Limited | 有限 | 制限的 | 노드 기반 | Node-based | 节点式 | ノードベース |
| LangChain/LangGraph | LangChain/LangGraph | LangChain/LangGraph | LangChain/LangGraph | Native | Partial | Partial | Via integration | ||||||||||||
| 폐쇄망(Air-gapped) 배포 | Air-gapped Deploy | 离线部署 | 閉域網デプロイ | ✔ | ✔ | ✔ | ✔ | ||||||||||||
| 라이선스 | License | 许可证 | ライセンス | Apache 2.0 | Apache 2.0 | Apache 2.0 | Sustainable Use |
Langflow의 차별점
LangChain & LangGraph 네이티브 호환
Langflow는 LangChain 위에 구축된 플랫폼입니다. LangChain의 컴포넌트(Retriever, Chain, Memory 등)를 네이티브로 사용할 수 있고, LangGraph의 멀티 에이전트 오케스트레이션도 Flow 안에서 구현할 수 있습니다. 다른 플랫폼들은 LangChain을 부분적으로만 지원하지만, Langflow는 LangChain 생태계의 비주얼 IDE 역할을 합니다.
Python 코드 완전 제어
Dify나 Flowise는 코드를 샌드박스 내에서만 실행하지만, Langflow의 Custom Component는 제한 없는 Python 환경에서 동작합니다. subprocess로 패키지를 설치하고, 사내 라이브러리를 import하며, 컴포넌트를 한번 작성해 여러 Flow에서 재사용할 수 있습니다.
폐쇄망(Air-gapped) 보안
Langflow를 자체 호스팅하면 프롬프트, 문서, 벡터 임베딩 등 모든 데이터가 사내 인프라를 벗어나지 않습니다. vLLM으로 호스팅한 로컬 모델만 사용하면 외부 API 호출이 전혀 발생하지 않아, GDPR이나 사내 보안 규정을 완벽히 준수할 수 있습니다. 이는 Make.com 같은 클라우드 전용 도구로는 불가능한 구성입니다.
What Sets Langflow Apart
Native LangChain & LangGraph Compatibility
Langflow is built on top of LangChain. It natively supports LangChain components (Retriever, Chain, Memory, etc.) and can implement LangGraph multi-agent orchestration within Flows. Other platforms only partially support LangChain; Langflow serves as the LangChain ecosystem's visual IDE.
Full Python Code Control
Dify and Flowise restrict code to sandboxed environments. Langflow's Custom Components run in an unrestricted Python environment — install packages via subprocess, import internal libraries, write once and reuse across multiple Flows.
Air-gapped Security
Self-hosted Langflow ensures all data — prompts, documents, vector embeddings — never leaves your infrastructure. Using only locally-hosted models via vLLM, zero external API calls are made, fully complying with GDPR and internal security policies. This is impossible with cloud-only tools like Make.com.
Langflow 的差异化优势
原生兼容 LangChain & LangGraph
Langflow 基于 LangChain 构建,原生支持 LangChain 组件,可在 Flow 中实现 LangGraph 多 Agent 编排。其他平台仅部分支持 LangChain,而 Langflow 是 LangChain 生态的可视化 IDE。
Python 代码完全控制
Dify 和 Flowise 将代码限制在沙盒中。Langflow 的 Custom Component 在无限制的 Python 环境中运行——可安装包、导入内部库、一次编写多处复用。
离线(Air-gapped)安全
自托管 Langflow 确保所有数据(Prompt、文档、向量嵌入)不离开内部基础设施。仅使用 vLLM 本地模型时零外部 API 调用,完全符合 GDPR 及内部安全策略。
Langflow の差別化ポイント
LangChain & LangGraph ネイティブ互換
Langflow は LangChain 上に構築されたプラットフォームです。LangChain コンポーネントをネイティブに使用でき、LangGraph のマルチエージェントオーケストレーションも Flow 内で実装できます。他のプラットフォームは LangChain を部分的にしかサポートしませんが、Langflow は LangChain エコシステムのビジュアル IDEです。
Python コード完全制御
Dify や Flowise はコードをサンドボックスに制限しますが、Langflow の Custom Component は制限のない Python 環境で動作します。パッケージインストール、社内ライブラリ import、一度書いて複数 Flow で再利用が可能です。
エアギャップ(閉域網)セキュリティ
セルフホストの Langflow はすべてのデータ(プロンプト、ドキュメント、ベクトル埋め込み)が社内インフラから出ません。vLLM ローカルモデルのみ使用すれば外部 API 呼び出しはゼロで、GDPR や社内セキュリティポリシーに完全準拠できます。
3. Component 소개
Langflow에서 모든 것은 컴포넌트로 시작합니다. 컴포넌트는 Flow를 구성하는 블록이며, 좌측 사이드바에서 캔버스로 드래그하여 사용합니다. 각 컴포넌트의 왼쪽은 입력 포트, 오른쪽은 출력 포트이며, 호환되는 포트끼리 선으로 연결합니다.
주요 컴포넌트 카테고리
3. Components Overview
Everything in Langflow starts with components. Components are the building blocks of Flows — drag them from the sidebar onto the canvas. Each component has input ports on the left and output ports on the right, connected by wires between compatible ports.
Key Component Categories
3. 组件介绍
Langflow 中一切从组件开始。组件是构成 Flow 的积木——从侧边栏拖到画布上使用。每个组件左侧是输入端口,右侧是输出端口,通过连线连接兼容的端口。
主要组件类别
3. コンポーネント紹介
Langflow ではすべてがコンポーネントから始まります。コンポーネントは Flow を構成するブロックで、左サイドバーからキャンバスにドラッグして使用します。各コンポーネントの左側が入力ポート、右側が出力ポートで、互換性のあるポート同士を線で繋ぎます。
主要コンポーネントカテゴリ
Inputs / Outputs
사용자와의 대화 인터페이스. Chat Input으로 메시지를 받고, Chat Output으로 응답을 보냅니다. Chat Output이 있어야 Playground가 활성화됩니다.
User conversation interface. Chat Input receives messages, Chat Output sends responses. Playground requires Chat Output to be present.
用户对话界面。Chat Input 接收消息,Chat Output 发送回复。需要 Chat Output 才能激活 Playground。
ユーザーとの対話インターフェース。Chat Input でメッセージを受け取り、Chat Output で応答を送ります。Chat Output がないと Playground は有効化されません。
Models
LLM 모델과 연동하는 컴포넌트. 폐쇄망(Air-gapped)에서는 OpenAI Compatible(1.11부터 Language Model의 Provider 옵션)로 사내 vLLM 서버에 연결합니다. Base URL과 모델명만 설정하면 됩니다.
Connects to LLM models. In air-gapped environments, use OpenAI Compatible (a Language Model provider option as of 1.11) to reach internal vLLM servers. Just set the Base URL and model name.
连接 LLM 模型。在封闭网络中,使用 OpenAI Compatible(1.11 起为 Language Model 的 Provider 选项)连接内部 vLLM 服务器。只需设置 Base URL 和模型名称。
LLM モデルと連携するコンポーネント。閉域網では OpenAI Compatible(1.11 から Language Model の Provider オプション)で社内 vLLM サーバーに接続します。Base URL とモデル名を設定するだけです。
Prompts
시스템 프롬프트와 템플릿을 정의합니다. {변수명} 형식으로 동적 변수를 삽입할 수 있어, 다양한 상황에 맞는 프롬프트를 구성합니다.
Define system prompts and templates. Use {variable} syntax to insert dynamic values for context-specific prompts.
定义系统提示词和模板。使用 {变量名} 格式插入动态变量,构建适应各种场景的提示词。
システムプロンプトとテンプレートを定義します。{変数名} 形式で動的変数を挿入でき、様々な状況に合ったプロンプトを構成できます。
Tools & Agents
Tools: Calculator, Python REPL 등 Agent가 호출할 수 있는 도구.
Agent: Tool을 자율적으로 선택/호출하여 작업을 수행하는 에이전트 컴포넌트.
Tools: Calculator, Python REPL, etc. — callable by the Agent.
Agent: Autonomously selects and calls Tools to accomplish tasks.
Tools:Calculator、Python REPL 等可被 Agent 调用的工具。
Agent:自主选择和调用工具执行任务的 Agent 组件。
Tools:Calculator、Python REPL など Agent が呼び出せるツール。
Agent:Tool を自律的に選択・呼び出してタスクを実行するエージェントコンポーネント。
Memories
대화 기록을 저장하고 관리합니다. Chat Memory를 연결하면 Agent가 이전 대화 맥락을 기억하여 자연스러운 멀티턴 대화가 가능합니다.
Stores and manages conversation history. Connect Chat Memory so the Agent remembers prior context for natural multi-turn conversations.
存储和管理对话历史。连接 Chat Memory 使 Agent 记住之前的对话上下文,实现自然的多轮对话。
会話履歴を保存・管理します。Chat Memory を接続すると Agent が過去の会話の文脈を記憶し、自然なマルチターン対話が可能になります。
Vector Stores & Embeddings
텍스트를 벡터로 변환(Embedding)하고 저장/검색합니다. Milvus, OpenSearch, PostgreSQL(pgvector) 등을 지원합니다. RAG 파이프라인 구축에 사용됩니다.
Convert text to vectors (Embedding) and store/search them. Supports Milvus, OpenSearch, PostgreSQL (pgvector), and more. Used for building RAG pipelines.
将文本转换为向量(Embedding)并存储/检索。支持 Milvus、OpenSearch、PostgreSQL (pgvector) 等。用于构建 RAG 管道。
テキストをベクトルに変換(Embedding)して保存・検索します。Milvus、OpenSearch、PostgreSQL (pgvector) などをサポート。RAG パイプライン構築に使用します。
메인 페이지: Knowledge & Files
Langflow 메인 페이지에서는 Flow 외에도 Knowledge와 Files를 관리할 수 있습니다.
Main Page: Knowledge & Files
Beyond Flows, the Langflow main page lets you manage Knowledge and Files.
主页:Knowledge 和 Files
除了 Flow,Langflow 主页还可以管理 Knowledge 和 Files。
メインページ:Knowledge & Files
Flow 以外にも、Langflow メインページでは Knowledge と Files を管理できます。
Knowledge (문서 컬렉션)
메인 페이지의 Knowledge 탭에서 RAG에 사용할 문서 컬렉션을 관리합니다. 별도 VectorDB 없이도 기본값인 로컬 Chroma에 임베딩을 적재하여 간단한 RAG를 구축할 수 있어, 초기 실험용으로 적합합니다.
Langflow 1.10부터는 DB Providers 설정으로 백엔드를 바꿀 수 있습니다 — Chroma(로컬, 기본값) / Chroma Cloud / OpenSearch.1.10
폐쇄망에서의 선택
Chroma Cloud는 외부 통신이 필요하므로 사용할 수 없습니다. 실험 단계에서는 로컬 Chroma로 충분하지만, 사내에 운영 중인 OpenSearch 클러스터가 있다면 프로덕션 RAG의 현실적인 선택지입니다. 로컬 Chroma는 Langflow 컨테이너의 수명에 묶여 있다는 점을 기억하세요.
Knowledge (Document Collections)
Manage document collections for RAG in the Knowledge tab on the main page. Without a separate VectorDB, embeddings land in local Chroma (the default) — ideal for initial experiments.
Since Langflow 1.10, the DB Providers setting lets you switch backends: Chroma (local, default) / Chroma Cloud / OpenSearch.1.10
Choosing in an air-gapped network
Chroma Cloud requires external connectivity, so it is not an option. Local Chroma is fine for experiments, but if your organization already runs an OpenSearch cluster, that's the realistic choice for production RAG. Remember that local Chroma is tied to the lifetime of the Langflow container.
Knowledge(文档集合)
在主页的 Knowledge 标签中管理用于 RAG 的文档集合。无需单独的 VectorDB,嵌入将存入默认的本地 Chroma——适合初期实验。
自 Langflow 1.10 起,可通过 DB Providers 设置切换后端:Chroma(本地,默认)/ Chroma Cloud / OpenSearch。1.10
封闭网络中的选择
Chroma Cloud 需要外部通信,无法使用。实验阶段本地 Chroma 已足够,但若公司已运行 OpenSearch 集群,那才是生产级 RAG 的现实选择。请注意本地 Chroma 的生命周期与 Langflow 容器绑定。
Knowledge(ドキュメントコレクション)
メインページの Knowledge タブで RAG 用のドキュメントコレクションを管理します。別途 VectorDB なしでもデフォルトのローカル Chroma にエンベディングを格納でき、初期の実験に最適です。
Langflow 1.10 からは DB Providers 設定でバックエンドを変更できます — Chroma(ローカル、デフォルト)/ Chroma Cloud / OpenSearch。1.10
閉域網での選択
Chroma Cloud は外部通信が必要なため使用できません。実験段階ならローカル Chroma で十分ですが、社内で OpenSearch クラスタを運用しているなら、本番 RAG の現実的な選択肢はそちらです。ローカル Chroma は Langflow コンテナの寿命に紐づく点に注意してください。


사전 설정 필수
Knowledge를 사용하려면 Global Model Provider에서 Embedding Model을 먼저 설정해야 합니다.

Required Setup
You must configure an Embedding Model in Global Model Provider before using Knowledge.
必须先设置
使用 Knowledge 前,需在 Global Model Provider 中先配置 Embedding Model。
事前設定必須
Knowledge を使用するには、Global Model Provider で Embedding Model を先に設定する必要があります。
Knowledge 생성 과정
- + Add Knowledge로 이름을 지정하고, Embedding Model과 Source(File 또는 Folder)를 추가합니다.
- Source 추가 후 Next Step에서 약 5개 Chunk를 미리보기할 수 있어, Chunk size와 delimiter를 간단히 테스트할 수 있습니다.
- Embedding 수행 시 선택한 DB Provider에 적재됩니다. 기본값은 Langflow 자체 로컬 Chroma입니다.
Creating Knowledge
- Click + Add Knowledge, set a name, select Embedding Model, and add Source (File or Folder).
- After adding sources, the Next Step shows a preview of ~5 chunks to test chunk size and delimiter settings.
- Embeddings are written to the selected DB Provider — Langflow's built-in local Chroma by default.
创建 Knowledge
- 点击 + Add Knowledge,设定名称,选择 Embedding Model,添加 Source(File 或 Folder)。
- 添加后下一步可预览约 5 个 Chunk,测试 Chunk size 和 delimiter 设置。
- Embedding 结果存入所选的 DB Provider,默认为 Langflow 自带的本地 Chroma。
Knowledge の作成
- + Add Knowledge で名前を指定し、Embedding Model と Source(File または Folder)を追加します。
- Source 追加後の Next Step で約5つの Chunk をプレビューでき、Chunk size と delimiter を簡単にテストできます。
- エンベディングは選択した DB Provider に格納されます。デフォルトは Langflow 自体のローカル Chroma です。


무엇을 바꿀 수 있고, 무엇을 못 바꾸나1.10+
데이터 추가는 가능합니다. 목록에서 More > Update Knowledge Base로 문서를 더할 수 있고, Flow 안에서는 Knowledge Base 컴포넌트를 Ingest 모드로 써서 DataFrame을 이어서 적재할 수 있습니다. 이때 컬럼에 Identifier를 지정하면 중복 적재를 걸러 줍니다(Allow Duplicates 기본 비활성).
반면 생성 시점에 고정되어 바꿀 수 없는 것이 있습니다 — Embedding Model과 DB Provider입니다. 이 둘을 바꾸려면 Knowledge를 삭제하고 다시 만들어야 합니다. 청킹 방식도 Embedding Model에 종속되므로 마찬가지입니다.
따라서 Embedding Model 선택이 사실상 되돌리기 어려운 결정입니다. 대량 적재 전에 Chunk 미리보기로 충분히 검증하세요.
What you can change, and what you can't1.10+
Adding data is supported. Use More > Update Knowledge Base from the list to add documents, or the Knowledge Base component in Ingest mode inside a flow to append a DataFrame. Marking a column as Identifier gives you duplicate detection (Allow Duplicates is off by default).
What is fixed at creation is the embedding model and the DB provider. Changing either means deleting and recreating the knowledge base — and since chunking behaviour follows the embedding model, that goes with it.
So the choice of embedding model is effectively irreversible. Validate it against the chunk preview before you ingest at scale.
哪些能改,哪些不能改1.10+
追加数据是支持的。可在列表中通过 More > Update Knowledge Base 添加文档,或在 Flow 中使用 Ingest 模式的 Knowledge Base 组件继续写入 DataFrame。将列标记为 Identifier 即可进行重复检测(Allow Duplicates 默认关闭)。
而在创建时即固定、无法更改的是 Embedding Model 与 DB Provider。若要更改,必须删除并重新创建知识库;分块方式取决于 Embedding Model,同理。
因此 Embedding Model 的选择实际上难以回退。请在大批量写入前通过 Chunk 预览充分验证。
変更できるもの、できないもの1.10+
データの追加は可能です。一覧から More > Update Knowledge Base でドキュメントを追加でき、Flow 内では Ingest モードの Knowledge Base コンポーネントで DataFrame を追記できます。列に Identifier を指定すると重複を検出します(Allow Duplicates は既定で無効)。
一方、作成時に固定され変更できないのが Embedding Model と DB Provider です。変更するには Knowledge を削除して作り直す必要があります。チャンク方式も Embedding Model に依存するため同様です。
したがって Embedding Model の選択は事実上やり直しの効かない決定です。大量投入の前に Chunk プレビューで十分に検証してください。

목록 우측 ⋮ 메뉴 — Update Knowledge / View Chunks / Delete. Embedding Model 열은 생성 후 변경할 수 없습니다.The ⋮ menu on each row — Update Knowledge / View Chunks / Delete. The Embedding Model column cannot be changed after creation.列表右侧 ⋮ 菜单 — Update Knowledge / View Chunks / Delete。Embedding Model 列在创建后无法更改。一覧右側の ⋮ メニュー — Update Knowledge / View Chunks / Delete。Embedding Model 列は作成後に変更できません。
Flow 내에서 Knowledge Base 컴포넌트를 사용하면 생성한 Knowledge를 언제든지 참조할 수 있습니다.
Use the Knowledge Base component in your Flow to reference created Knowledge at any time.
在 Flow 中使用 Knowledge Base 组件可随时引用已创建的 Knowledge。
Flow 内で Knowledge Base コンポーネントを使うと、作成した Knowledge をいつでも参照できます。

Files (파일 관리)
메인 페이지의 My Files 탭에서 Langflow 환경의 파일을 중앙 관리합니다.
Files (File Management)
Centrally manage files in the My Files tab on the main page.
Files(文件管理)
在主页的 My Files 标签中集中管理文件。
Files(ファイル管理)
メインページの My Files タブで Langflow 環境のファイルを一元管理します。


- PDF, CSV, TXT, JSON 등을 업로드하여 여러 Flow에서 공유 가능
- Flow에서 File 컴포넌트로 업로드한 파일을 직접 참조하여 데이터를 읽어올 수 있습니다.
- Read File 컴포넌트(위 두 번째 이미지)를 사용하면 My Files에 업로드된 파일을 Flow 안에서 직접 읽어올 수 있습니다. 파일 경로를 지정하거나 목록에서 선택하여 텍스트 데이터를 추출합니다.
- 파일을 한 곳에서 관리하므로, 동일한 파일을 여러 Flow에 중복 업로드할 필요가 없습니다.
- Upload PDF, CSV, TXT, JSON, etc. and share across multiple Flows
- Use the File component in Flows to directly reference uploaded files and read data.
- The Read File component (second image above) lets you read files uploaded to My Files directly within a Flow. Specify the file path or select from the list to extract text data.
- Centralized file management eliminates the need to upload the same file to multiple Flows.
- 上传 PDF、CSV、TXT、JSON 等,可在多个 Flow 中共享
- 在 Flow 中使用 File 组件直接引用已上传的文件来读取数据。
- Read File 组件(上方第二张图片)可在 Flow 中直接读取已上传到 My Files 的文件。指定文件路径或从列表中选择来提取文本数据。
- 集中管理文件,无需在多个 Flow 中重复上传相同文件。
- PDF、CSV、TXT、JSON などをアップロードし、複数の Flow で共有可能
- Flow の File コンポーネントでアップロードしたファイルを直接参照してデータを読み込めます。
- Read File コンポーネント(上の2番目の画像)を使うと、My Files にアップロードしたファイルを Flow 内で直接読み取れます。ファイルパスを指定するか、リストから選択してテキストデータを抽出します。
- ファイルを一箇所で管理するため、同じファイルを複数の Flow に重複アップロードする必要がありません。
Air-gapped 환경에서 vLLM 활용
Langflow는 기본적으로 Anthropic, Google Generative AI, IBM Watson X, Ollama, OpenAI 등 유료/외부 Model Provider를 지원합니다. 하지만 폐쇄망(Air-gapped) 환경에서는 외부 API에 접근할 수 없으므로, 사내 GPU 서버에서 vLLM으로 호스팅한 모델을 사용해야 합니다.
Langflow는 vLLM 및 vLLM Embeddings 컴포넌트를 기본 제공하여, OpenAI-compatible API 형태로 서빙되는 vLLM 서버에 바로 연결할 수 있습니다. 이를 통해 폐쇄망(Air-gapped)에서도 LLM 기반 텍스트 생성과 임베딩을 활용한 RAG 파이프라인을 구성할 수 있습니다.
Using vLLM in Air-gapped Environments
Langflow natively supports external Model Providers such as Anthropic, Google Generative AI, IBM Watson X, Ollama, and OpenAI. However, in air-gapped environments where external APIs are inaccessible, you need to use models hosted via vLLM on internal GPU servers.
Langflow provides built-in vLLM and vLLM Embeddings components that connect directly to vLLM servers serving OpenAI-compatible APIs. This enables LLM-based text generation and embedding-powered RAG pipelines even in air-gapped networks.
在离线环境中使用 vLLM
Langflow 默认支持 Anthropic、Google Generative AI、IBM Watson X、Ollama、OpenAI 等外部 Model Provider。但在离线(Air-gapped)环境中无法访问外部 API,需要使用内部 GPU 服务器上通过 vLLM 托管的模型。
Langflow 内置 vLLM 和 vLLM Embeddings 组件,可直接连接以 OpenAI-compatible API 形式提供服务的 vLLM 服务器。这使得在离线网络中也能构建基于 LLM 的文本生成和嵌入驱动的 RAG 管道。
エアギャップ環境での vLLM 活用
Langflow はデフォルトで Anthropic、Google Generative AI、IBM Watson X、Ollama、OpenAI などの外部 Model Provider をサポートしています。しかし、エアギャップ(閉域網)環境では外部 API にアクセスできないため、社内 GPU サーバーで vLLM を使用してホスティングしたモデルを利用する必要があります。
Langflow は vLLM および vLLM Embeddings コンポーネントを標準搭載しており、OpenAI-compatible API として提供される vLLM サーバーに直接接続できます。これにより、閉域網でも LLM ベースのテキスト生成やエンベディングを活用した RAG パイプラインを構築できます。
Provider 방식 vs vLLM 방식 비교
vLLM은 UC Berkeley의 Woosuk Kwon 등이 개발한 고성능 LLM 추론 엔진입니다 (논문 | 공식 문서). PagedAttention 기법으로 GPU 메모리를 효율적으로 관리하며, OpenAI-compatible API를 제공하여 다양한 오픈소스 모델을 쉽게 서빙할 수 있습니다.
Langflow에는 범용 Embedding Model과 Language Model 컴포넌트도 있습니다. 이들은 Provider 드롭다운에서 Anthropic, OpenAI 등 외부 서비스를 선택하는 방식입니다. 반면 vLLM 컴포넌트는 사내 GPU에서 직접 호스팅한 모델의 API Base URL을 지정하여 연결하므로, 폐쇄망(Air-gapped)에서 외부 Provider 없이 사용할 수 있습니다.
Provider vs vLLM Comparison
vLLM is a high-performance LLM inference engine developed by Woosuk Kwon et al. at UC Berkeley (paper | docs). It uses PagedAttention for efficient GPU memory management and provides an OpenAI-compatible API for serving various open-source models.
Langflow also provides generic Embedding Model and Language Model components, which select external services like Anthropic or OpenAI from a Provider dropdown. In contrast, vLLM components connect by specifying the API Base URL of models self-hosted on internal GPUs — usable in air-gapped networks without external providers.
Provider 方式 vs vLLM 方式对比
vLLM 是由加州大学伯克利分校的 Woosuk Kwon 等人开发的高性能 LLM 推理引擎(论文 | 官方文档)。它使用 PagedAttention 技术高效管理 GPU 内存,并提供 OpenAI-compatible API 来服务各种开源模型。
Langflow 还提供通用的 Embedding Model 和 Language Model 组件,通过 Provider 下拉菜单选择 Anthropic、OpenAI 等外部服务。而 vLLM 组件通过指定内部 GPU 服务器上自托管模型的 API Base URL 连接——可在无外部 Provider 的离线网络中使用。
Provider 方式 vs vLLM 方式の比較
vLLM は UC Berkeley の Woosuk Kwon らが開発した高性能 LLM 推論エンジンです(論文 | 公式ドキュメント)。PagedAttention で GPU メモリを効率的に管理し、OpenAI-compatible API で様々なオープンソースモデルを簡単にサービングできます。
Langflow には汎用の Embedding Model と Language Model コンポーネントもあります。これらは Provider ドロップダウンから Anthropic や OpenAI などの外部サービスを選択する方式です。一方、vLLM コンポーネントは社内 GPU でセルフホストしたモデルの API Base URL を指定して接続するため、外部 Provider なしの閉域網で使用できます。
Embedding Model
Provider 드롭다운에서 외부 서비스를 선택하여 임베딩을 생성합니다. 인터넷 연결과 API Key가 필요합니다.
Select an external provider from the dropdown to generate embeddings. Requires internet access and an API key.
从 Provider 下拉菜单选择外部服务生成嵌入。需要网络连接和 API Key。
Provider ドロップダウンから外部サービスを選択してエンベディングを生成します。インターネット接続と API Key が必要です。

vLLM Embeddings
사내 vLLM 서버의 API Base URL과 Model Name(예: bge-m3)을 직접 지정합니다. 폐쇄망(Air-gapped)에서 외부 Provider 없이 임베딩 생성이 가능합니다.
Directly specify the API Base URL and Model Name (e.g., bge-m3) of your internal vLLM server. Enables embedding generation in air-gapped networks without external providers.
直接指定内部 vLLM 服务器的 API Base URL 和 Model Name(例:bge-m3)。无需外部 Provider 即可在离线网络中生成嵌入。
社内 vLLM サーバーの API Base URL と Model Name(例:bge-m3)を直接指定します。外部 Provider なしで閉域網でのエンベディング生成が可能です。

Language Model
Provider 드롭다운에서 LLM 서비스를 선택하여 텍스트를 생성합니다. Anthropic, OpenAI 등 외부 Provider는 인터넷과 API Key가 필요하지만, 1.11부터 추가된 OpenAI Compatible Provider를 고르면 사내 vLLM 같은 임의의 OpenAI 호환 엔드포인트를 직접 지정할 수 있습니다.1.11
Select an LLM provider from the dropdown to generate text. External providers (Anthropic, OpenAI, …) need internet and an API key, but the OpenAI Compatible provider added in 1.11 lets you point at any OpenAI-compatible endpoint, such as an internal vLLM server.1.11
从 Provider 下拉菜单选择 LLM 服务生成文本。Anthropic、OpenAI 等外部 Provider 需要网络和 API Key,但选择 1.11 新增的 OpenAI Compatible Provider 即可直接指定内部 vLLM 等任意 OpenAI 兼容端点。1.11
Provider ドロップダウンから LLM サービスを選択してテキストを生成します。Anthropic や OpenAI などの外部 Provider はインターネットと API Key が必要ですが、1.11 で追加された OpenAI Compatible Provider を選べば社内 vLLM のような任意の OpenAI 互換エンドポイントを直接指定できます。1.11

vLLM
사내 vLLM 서버의 API Base URL과 Model Name(예: GLM-5.2)을 직접 지정합니다. Temperature 등 파라미터도 조절 가능합니다. 폐쇄망(Air-gapped)에서 LLM 텍스트 생성이 가능합니다.
Directly specify the API Base URL and Model Name (e.g., GLM-5.2) of your internal vLLM server. Adjust parameters like Temperature. Enables LLM text generation in air-gapped networks.
直接指定内部 vLLM 服务器的 API Base URL 和 Model Name(例:GLM-5.2)。可调节 Temperature 等参数。在离线网络中实现 LLM 文本生成。
社内 vLLM サーバーの API Base URL と Model Name(例:GLM-5.2)を直接指定します。Temperature などのパラメータも調整可能です。閉域網での LLM テキスト生成が可能です。

"OpenAI Compatible"은 컴포넌트인가, Provider인가?1.11
둘 다 맞습니다 — 버전에 따라 위치가 다를 뿐입니다. 1.10 이하에서는 사이드바에 독립 컴포넌트로 있었지만, 1.11에서는 Language Model 컴포넌트의 Provider 드롭다운 옵션으로 승격되었습니다. 설정 항목(Base URL, Model Name, API Key)과 연동 방식은 동일합니다.
본 가이드는 이후 절에서 편의상 "OpenAI Compatible"로 통칭합니다. 1.11 이상을 쓰신다면 Language Model 컴포넌트를 놓고 Provider를 OpenAI Compatible로 선택한다고 읽으시면 됩니다. 사내 GPU 서버를 쓰는 전용 vLLM 컴포넌트는 두 버전 모두에서 그대로 사용 가능합니다.
Is "OpenAI Compatible" a component or a provider?1.11
Both — only its location changed. On 1.10 and earlier it was a standalone component in the sidebar; in 1.11 it became a Provider option inside the Language Model component. The settings (Base URL, Model Name, API Key) and the way you connect are unchanged.
For brevity, the rest of this guide says "OpenAI Compatible". On 1.11+, read that as drop a Language Model component and set Provider to OpenAI Compatible. The dedicated vLLM component for internal GPU servers works the same on both versions.
"OpenAI Compatible" 是组件还是 Provider?1.11
都对——只是位置不同。1.10 及以前它是侧边栏中的独立组件;1.11 起升级为 Language Model 组件内的 Provider 选项。设置项(Base URL、Model Name、API Key)和连接方式完全相同。
为简洁起见,本指南后续统称 "OpenAI Compatible"。若使用 1.11 以上版本,请理解为放置 Language Model 组件并将 Provider 选为 OpenAI Compatible。用于内部 GPU 服务器的专用 vLLM 组件在两个版本中均可照常使用。
「OpenAI Compatible」はコンポーネント?それとも Provider?1.11
どちらも正解です — バージョンによって位置が違うだけです。1.10 以前はサイドバーの独立コンポーネントでしたが、1.11 では Language Model コンポーネントの Provider ドロップダウン項目に昇格しました。設定項目(Base URL、Model Name、API Key)と連携方法は同じです。
本ガイドでは以降、便宜上 「OpenAI Compatible」 と総称します。1.11 以上をお使いの場合はLanguage Model コンポーネントを配置し Provider を OpenAI Compatible に設定すると読み替えてください。社内 GPU サーバー用の専用 vLLM コンポーネントは両バージョンでそのまま使用できます。
컴포넌트 연결 시 Port Type(색상)의 중요성
Langflow에서 컴포넌트를 연결할 때, 각 포트에는 데이터 타입에 따른 고유한 색상이 부여됩니다. 같은 색상(같은 타입)의 포트끼리만 연결할 수 있으며, 호환되지 않는 타입의 포트를 연결하려 하면 선이 연결되지 않습니다. 이 색상 시스템을 이해하면 Flow를 더 빠르고 정확하게 구성할 수 있습니다.
Port Type (Color) Matters When Connecting Components
When connecting components in Langflow, each port is assigned a unique color based on its data type. Only ports of the same color (same type) can be connected — incompatible types won't link. Understanding this color system helps you build Flows faster and more accurately.
连接组件时 Port Type(颜色)的重要性
在 Langflow 中连接组件时,每个端口根据数据类型分配唯一的颜色。只有相同颜色(相同类型)的端口才能连接——不兼容的类型无法链接。理解此颜色系统有助于更快、更准确地构建 Flow。
コンポーネント接続時の Port Type(色)の重要性
Langflow でコンポーネントを接続する際、各ポートにはデータ型に応じた固有の色が割り当てられます。同じ色(同じ型)のポート同士のみ接続可能で、互換性のない型のポートは繋がりません。この色システムを理解すると Flow をより速く正確に構成できます。
| 데이터 타입 | Data Type | 数据类型 | データ型 | 포트 색상 | Port Color | 端口颜色 | ポート色 | 아이콘 | Icon | 图标 | アイコン |
|---|---|---|---|---|---|---|---|---|---|---|---|
| JSON | Red | Red | Red | Red | |||||||
| Table | Pink | Pink | Pink | Pink | |||||||
| Embeddings | Emerald | Emerald | Emerald | Emerald | |||||||
| LanguageModel | Fuchsia | Fuchsia | Fuchsia | Fuchsia | |||||||
| Memory | Orange | Orange | Orange | Orange | |||||||
| Message | Indigo | Indigo | Indigo | Indigo | |||||||
| Tool | Cyan | Cyan | Cyan | Cyan | |||||||
| Unknown / 복합 타입 | Unknown / Multiple | Unknown / 多类型 | Unknown / 複合型 | Gray | Gray | Gray | Gray |
TIP: Gray 포트의 활용
Gray(Unknown/복합 타입) 포트는 여러 데이터 타입을 모두 수용할 수 있는 범용 포트입니다. 어떤 색상의 포트든 Gray 포트에 연결할 수 있으므로, 다양한 타입의 데이터를 하나의 입력으로 받아야 할 때 유용합니다.
TIP: Gray Port Usage
Gray (Unknown/Multiple) ports accept various data types. Any colored port can connect to a Gray port, making it useful when a component needs to accept diverse input types.
提示:Gray 端口的使用
Gray(Unknown/多类型)端口可接受多种数据类型。任何颜色的端口都可以连接到 Gray 端口,适用于需要接受多种输入类型的场景。
TIP:Gray ポートの活用
Gray(Unknown/複合型)ポートは様々なデータ型を受け入れる汎用ポートです。どの色のポートでも Gray ポートに接続できるため、多様な型のデータを一つの入力で受ける必要がある場合に便利です。
Data Operations: 하나의 컴포넌트로 Text · JSON · Table 처리1.11
Langflow 1.11부터 기존의 Text Operations, JSON Operations, Table Operations 세 컴포넌트가 Data Operations 하나로 통합되었습니다. 컴포넌트 안의 Input Type 셀렉터로 처리할 데이터 종류를 고르면, 그에 맞는 연산 목록이 나타납니다.
덕분에 "이 데이터는 Text인가 Table인가"에 따라 컴포넌트를 갈아끼울 필요가 없어졌고, 파이프라인 중간에 데이터 형태가 바뀌어도 같은 컴포넌트로 이어갈 수 있습니다.
Data Operations: One Component for Text, JSON, and Table1.11
As of Langflow 1.11, the former Text Operations, JSON Operations, and Table Operations components are consolidated into a single Data Operations component. Pick your data kind with the Input Type selector inside the component, and the matching operation list appears.
You no longer swap components based on whether the data is Text or Table, and when the shape changes mid-pipeline you can keep going with the same component.
Data Operations:一个组件处理 Text · JSON · Table1.11
从 Langflow 1.11 起,原先的 Text Operations、JSON Operations、Table Operations 三个组件已合并为单一的 Data Operations 组件。通过组件内的 Input Type 选择器指定数据类型,即可显示对应的操作列表。
不再需要根据数据是 Text 还是 Table 来更换组件,管道中途数据形态改变时也可用同一组件继续处理。
Data Operations:1つのコンポーネントで Text · JSON · Table を処理1.11
Langflow 1.11 から、従来の Text Operations、JSON Operations、Table Operations の3コンポーネントが Data Operations 1つに統合されました。コンポーネント内の Input Type セレクタで扱うデータ種別を選ぶと、それに応じた演算リストが表示されます。
データが Text か Table かでコンポーネントを差し替える必要がなくなり、パイプライン途中でデータ形態が変わっても同じコンポーネントで続けられます。
| Input TypeInput TypeInput TypeInput Type | 주요 연산Available operations主要操作主な演算 |
|---|---|
| Text | Word Count, Case Convert, Replace, Extract, Head/Tail, Strip, Join, Clean, Text→DataFrame |
| JSON | Select Keys, Literal Eval, Combine, Filter Values, Append/Update, Remove Keys, Rename Keys, Path Selection, JQ Expression |
| Table | Add/Drop/Rename Column, Concatenate, Filter, Head/Tail, Merge, Replace Value, Select Columns, Sort, Drop Duplicates |
1.10 이하에서 만든 Flow는?
기존 Text/JSON/Table Operations 컴포넌트는 legacy로 표시되지만 그대로 동작합니다. 이미 만들어 둔 Flow를 급하게 고칠 필요는 없으며, 새로 만드는 Flow부터 Data Operations를 쓰면 됩니다.
Input Type = Table: 여러 Table 입력 한 번에 연결
Table 모드에서는 여러 Table 타입 컴포넌트의 출력을 하나의 입력에 동시에 연결할 수 있습니다. 예를 들어 Read File로 읽어온 CSV 테이블 여러 개나 SpreadSheet 컴포넌트의 출력을 한꺼번에 넣어 병합(Merge)하거나 비교 연산을 수행합니다.
What about flows built on 1.10 or earlier?
The old Text/JSON/Table Operations components are marked legacy but still work. There's no rush to rewrite existing flows — just use Data Operations for new ones.
Input Type = Table: Connect Multiple Table Inputs at Once
In Table mode you can connect multiple Table-type outputs to a single input simultaneously. For example, feed in several CSV tables loaded via Read File, or SpreadSheet component outputs, all at once to Merge or compare them in one step.
1.10 及以前创建的 Flow 怎么办?
原有的 Text/JSON/Table Operations 组件虽标记为 legacy,但仍可正常运行。无需急于修改已有 Flow,新建的 Flow 使用 Data Operations 即可。
Input Type = Table:一次连接多个 Table 输入
在 Table 模式下,可将多个 Table 类型组件的输出同时连接到一个输入。例如把通过 Read File 读取的多个 CSV 表或 SpreadSheet 组件的输出一并输入,进行合并(Merge)或比较运算。
1.10 以前で作成した Flow は?
従来の Text/JSON/Table Operations コンポーネントは legacy と表示されますがそのまま動作します。既存の Flow を急いで修正する必要はなく、新規作成分から Data Operations を使えば十分です。
Input Type = Table:複数の Table 入力を一括接続
Table モードでは複数の Table 型コンポーネントの出力を1つの入力に同時接続できます。例えば Read File で読み込んだ複数の CSV テーブルや SpreadSheet コンポーネントの出力をまとめて入力し、マージ(Merge)や比較演算を実行します。
Input Type: Table
포트 색상으로 확인
Table 타입 포트는 Pink 색입니다. Read File, SpreadSheet 등의 Table 출력 포트(Pink)가 Data Operations의 Table 입력 포트(Pink)와 같은 색이므로 자유롭게 연결할 수 있습니다. 여러 개의 Table 포트를 하나의 입력에 연결하면 자동으로 다중 입력으로 처리됩니다.
Verify by Port Color
Table-type ports are Pink. The Table output ports (Pink) from Read File, SpreadSheet, etc. match Data Operations' Table input port (Pink), so they connect freely. Connecting multiple Table ports to a single input automatically handles them as multiple inputs.
通过端口颜色确认
Table 类型端口为 Pink 色。Read File、SpreadSheet 等的 Table 输出端口(Pink)与 Data Operations 的 Table 输入端口(Pink)颜色相同,可自由连接。将多个 Table 端口连接到同一输入会自动处理为多输入。
ポート色で確認
Table 型ポートは Pink 色です。Read File や SpreadSheet などの Table 出力ポート(Pink)は Data Operations の Table 入力ポート(Pink)と同色なので自由に接続できます。複数の Table ポートを1つの入力に接続すると自動的に多重入力として処理されます。
퀴즈
Quiz
测验
クイズ
폐쇄망(Air-gapped) 환경에서 LLM을 사용하려면 어떤 컴포넌트를 선택해야 하나요?
Which component should you use to run an LLM in an air-gapped environment?
在离线环境中运行 LLM 应该选择哪个组件?
エアギャップ環境で LLM を使うにはどのコンポーネントを選ぶべきですか?
정답 보기
Show Answer
查看答案
答えを見る
vLLM 컴포넌트, 또는 Language Model 컴포넌트에서 Provider를 OpenAI Compatible로 지정합니다. 핵심은 API Base URL을 사내 서버로 직접 지정할 수 있는지입니다. Anthropic, OpenAI 같은 외부 Provider를 고르면 인터넷이 필요하므로 폐쇄망에서 동작하지 않습니다.
Use the vLLM component, or a Language Model component with Provider set to OpenAI Compatible. What matters is whether you can point the API Base URL at an internal server. Picking an external provider like Anthropic or OpenAI requires internet and won't work air-gapped.
使用 vLLM 组件,或将 Language Model 组件的 Provider 设为 OpenAI Compatible。关键在于能否将 API Base URL 直接指向内部服务器。若选择 Anthropic、OpenAI 等外部 Provider 则需要互联网,在封闭网络中无法运行。
vLLM コンポーネント、または Language Model コンポーネントで Provider を OpenAI Compatible に指定します。要点は API Base URL を社内サーバーに直接指定できるかです。Anthropic や OpenAI などの外部 Provider を選ぶとインターネットが必要になり、閉域網では動作しません。
4. Custom Component 만들기
기본 컴포넌트로 부족할 때, Python으로 Custom Component를 직접 작성합니다. 가장 기초부터 시작해 봅시다.
4. Building Custom Components
When built-in components aren't enough, write Custom Components in Python. Let's start from the basics.
4. 创建自定义组件
当内置组件不足时,使用 Python 编写自定义组件。从最基础开始。
4. カスタムコンポーネントの作成
組み込みコンポーネントで不足する場合は、Python でカスタムコンポーネントを直接作成します。まず基礎から始めましょう。
Step 1. 가장 기본 (Input 1개 + Output 1개)
입력 텍스트를 그대로 출력하는 최소 컴포넌트입니다.
Step 1. The Simplest (1 Input + 1 Output)
A minimal component that passes input text through.
Step 1. 最基本(1个输入 + 1个输出)
将输入文本原样输出的最简组件。
Step 1. 最も基本的な構成(Input 1つ + Output 1つ)
入力テキストをそのまま出力する最小構成のコンポーネントです。
from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data


class HelloComponent(Component):
    display_name = "안녕 컴포넌트"
    description = "입력을 그대로 출력하는 기본 컴포넌트"

    inputs = [
        StrInput(name="input_text", display_name="입력 텍스트", required=True),
    ]

    outputs = [
        Output(display_name="결과", name="result", method="run"),
    ]

    def run(self) -> Data:
        self.status = self.input_text
return Data(data={"text": self.input_text})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class HelloComponent(Component):
display_name = "Hello Component"
description = "A basic component that passes input through"
inputs = [
StrInput(name="input_text", display_name="Input Text", required=True),
]
outputs = [
Output(display_name="Result", name="result", method="run"),
]
def run(self) -> Data:
self.status = self.input_text
return Data(data={"text": self.input_text})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class HelloComponent(Component):
display_name = "你好组件"
description = "将输入原样输出的基本组件"
inputs = [
StrInput(name="input_text", display_name="输入文本", required=True),
]
outputs = [
Output(display_name="结果", name="result", method="run"),
]
def run(self) -> Data:
self.status = self.input_text
return Data(data={"text": self.input_text})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class HelloComponent(Component):
display_name = "ハローコンポーネント"
description = "入力をそのまま出力する基本コンポーネント"
inputs = [
StrInput(name="input_text", display_name="入力テキスト", required=True),
]
outputs = [
Output(display_name="結果", name="result", method="run"),
]
def run(self) -> Data:
self.status = self.input_text
return Data(data={"text": self.input_text})
StrInput & Output 인자 설명
Custom Component의 inputs와 outputs에서 사용하는 주요 인자(argument)를 정리합니다.
StrInput 주요 인자
StrInput & Output Arguments
Key arguments used in Custom Component inputs and outputs.
StrInput Arguments
StrInput 和 Output 参数说明
自定义组件 inputs 和 outputs 中使用的主要参数。
StrInput 参数
StrInput と Output の引数説明
カスタムコンポーネントの inputs と outputs で使用する主要な引数をまとめます。
StrInput の主要引数
| 인자 | Argument | 参数 | 引数 | 필수 | Required | 必需 | 必須 | 설명 | Description | 说明 | 説明 |
|---|---|---|---|---|---|---|---|---|---|---|---|
name | name | name | name | O | Yes | 是 | ○ | Python 변수명. self.name으로 접근 | Python variable name. Access via self.name | Python 变量名。通过 self.name 访问 | Python 変数名。self.name でアクセス |
display_name | display_name | display_name | display_name | O | Yes | 是 | ○ | UI에 표시되는 이름 | Label shown in the UI | UI 中显示的名称 | UI に表示される名前 |
info | info | info | info | X | No | 否 | × | 입력 필드 아래 표시되는 설명 텍스트 | Help text shown below the input field | 输入字段下方的说明文本 | 入力フィールド下部に表示される説明テキスト |
required | required | required | required | X | No | 否 | × | True면 필수 입력 (기본: False) | True = mandatory (default: False) | True 为必填(默认:False) | True で必須入力(デフォルト:False) |
value | value | value | value | X | No | 否 | × | 기본값 설정 | Default value | 默认值 | デフォルト値の設定 |
advanced | advanced | advanced | advanced | X | No | 否 | × | True면 고급 설정에 숨김 | True = hidden in advanced section | True 则隐藏在高级设置中 | True で詳細設定に非表示 |
Output 주요 인자
Output Arguments
Output 参数
Output の主要引数
| 인자 | Argument | 参数 | 引数 | 설명 | Description | 说明 | 説明 |
|---|---|---|---|---|---|---|---|
display_name | display_name | display_name | display_name | UI에 표시되는 출력 포트 이름 | Label shown on the output port in UI | UI 中输出端口显示的名称 | UI に表示される出力ポートの名前 |
name | name | name | name | 출력 식별자 (코드 내부에서 참조) | Output identifier (referenced internally) | 输出标识符(内部引用) | 出力識別子(コード内部から参照) |
method | method | method | method | 이 출력이 호출할 메서드 이름 (문자열) | Method name this output will invoke (string) | 此输出调用的方法名称(字符串) | この出力が呼び出すメソッド名(文字列) |
Step 2. 처리 로직 추가 (Input 2개)
두 번째 Input을 추가하여 텍스트를 가공합니다.
Step 2. Adding Logic (2 Inputs)
Add a second input with processing logic.
Step 2. 添加处理逻辑(2个输入)
添加第二个输入并加入处理逻辑。
Step 2. 処理ロジックの追加(Input 2つ)
2つ目の Input を追加してテキストを加工します。
from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data


class TextProcessor(Component):
    display_name = "텍스트 처리기"
    description = "접두사를 붙여 텍스트를 처리합니다"

    inputs = [
        StrInput(name="input_text", display_name="입력 텍스트", required=True),
        StrInput(name="prefix", display_name="접두사", value="[처리됨]"),
    ]

    outputs = [
        Output(display_name="처리 결과", name="processed", method="process_text"),
    ]

    def process_text(self) -> Data:
        result = f"{self.prefix} {self.input_text}"
        self.status = result
return Data(data={"text": result})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class TextProcessor(Component):
display_name = "Text Processor"
description = "Processes text by adding a prefix"
inputs = [
StrInput(name="input_text", display_name="Input Text", required=True),
StrInput(name="prefix", display_name="Prefix", value="[Processed]"),
]
outputs = [
Output(display_name="Result", name="processed", method="process_text"),
]
def process_text(self) -> Data:
result = f"{self.prefix} {self.input_text}"
self.status = result
return Data(data={"text": result})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class TextProcessor(Component):
display_name = "文本处理器"
description = "通过添加前缀处理文本"
inputs = [
StrInput(name="input_text", display_name="输入文本", required=True),
StrInput(name="prefix", display_name="前缀", value="[已处理]"),
]
outputs = [
Output(display_name="处理结果", name="processed", method="process_text"),
]
def process_text(self) -> Data:
result = f"{self.prefix} {self.input_text}"
self.status = result
return Data(data={"text": result})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class TextProcessor(Component):
display_name = "テキスト処理器"
description = "接頭辞を付けてテキストを処理します"
inputs = [
StrInput(name="input_text", display_name="入力テキスト", required=True),
StrInput(name="prefix", display_name="接頭辞", value="[処理済み]"),
]
outputs = [
Output(display_name="処理結果", name="processed", method="process_text"),
]
def process_text(self) -> Data:
result = f"{self.prefix} {self.input_text}"
self.status = result
return Data(data={"text": result})
Step 3. 여러 Output 추가
하나의 컴포넌트에서 여러 Output을 제공할 수 있습니다.
Step 3. Multiple Outputs
A single component can provide multiple outputs.
Step 3. 多个输出
一个组件可以提供多个输出。
Step 3. 複数の Output の追加
1つのコンポーネントから複数の Output を提供できます。
from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data


class TextAnalyzer(Component):
    display_name = "텍스트 분석기"
    description = "텍스트를 분석하여 여러 결과를 출력합니다"

    inputs = [
        StrInput(name="input_text", display_name="입력 텍스트", required=True),
    ]

    outputs = [
        Output(display_name="원본", name="original", method="get_original"),
        Output(display_name="대문자", name="upper", method="get_upper"),
        Output(display_name="통계", name="stats", method="get_stats"),
    ]

    def get_original(self) -> Data:
        return Data(data={"text": self.input_text})

    def get_upper(self) -> Data:
        return Data(data={"text": self.input_text.upper()})

    def get_stats(self) -> Data:
        stats = f"글자수: {len(self.input_text)}, 단어수: {len(self.input_text.split())}"
        self.status = stats
return Data(data={"text": stats})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class TextAnalyzer(Component):
display_name = "Text Analyzer"
description = "Analyzes text and outputs multiple results"
inputs = [
StrInput(name="input_text", display_name="Input Text", required=True),
]
outputs = [
Output(display_name="Original", name="original", method="get_original"),
Output(display_name="Uppercase", name="upper", method="get_upper"),
Output(display_name="Statistics", name="stats", method="get_stats"),
]
def get_original(self) -> Data:
return Data(data={"text": self.input_text})
def get_upper(self) -> Data:
return Data(data={"text": self.input_text.upper()})
def get_stats(self) -> Data:
stats = f"Characters: {len(self.input_text)}, Words: {len(self.input_text.split())}"
self.status = stats
return Data(data={"text": stats})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class TextAnalyzer(Component):
display_name = "文本分析器"
description = "分析文本并输出多个结果"
inputs = [
StrInput(name="input_text", display_name="输入文本", required=True),
]
outputs = [
Output(display_name="原文", name="original", method="get_original"),
Output(display_name="大写", name="upper", method="get_upper"),
Output(display_name="统计", name="stats", method="get_stats"),
]
def get_original(self) -> Data:
return Data(data={"text": self.input_text})
def get_upper(self) -> Data:
return Data(data={"text": self.input_text.upper()})
def get_stats(self) -> Data:
stats = f"字符数: {len(self.input_text)}, 词数: {len(self.input_text.split())}"
self.status = stats
return Data(data={"text": stats})from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data
class TextAnalyzer(Component):
display_name = "テキスト分析器"
description = "テキストを分析して複数の結果を出力します"
inputs = [
StrInput(name="input_text", display_name="入力テキスト", required=True),
]
outputs = [
Output(display_name="原文", name="original", method="get_original"),
Output(display_name="大文字", name="upper", method="get_upper"),
Output(display_name="統計", name="stats", method="get_stats"),
]
def get_original(self) -> Data:
return Data(data={"text": self.input_text})
def get_upper(self) -> Data:
return Data(data={"text": self.input_text.upper()})
def get_stats(self) -> Data:
stats = f"文字数: {len(self.input_text)}, 単語数: {len(self.input_text.split())}"
self.status = stats
return Data(data={"text": stats})
Step 4. Tool Mode로 Agent에 연결하기
Custom Component를 Tool Mode로 전환하면 Agent가 자율적으로 호출할 수 있는 도구가 됩니다. 코드에서 tool_mode=True를 Input에 설정하면 해당 입력이 Tool로 노출됩니다.
Tool Mode 활성화
컴포넌트 헤더 메뉴(⋮) → Tool Mode ON → Toolset 출력 포트 생성 → Agent의 Tools 입력에 연결
Step 4. Connecting to Agent via Tool Mode
Converting to Tool Mode turns your component into a tool the Agent can invoke. Set tool_mode=True on Inputs to expose them as tool parameters.
Activating Tool Mode
Header menu (⋮) → Tool Mode ON → Toolset output port appears → Connect to Agent's Tools input
Step 4. 通过工具模式连接 Agent
转换为工具模式后,组件成为 Agent 可自主调用的工具。在 Input 中设置 tool_mode=True 来将其暴露为工具参数。
激活工具模式
标题栏菜单(⋮) → 开启 Tool Mode → 出现 Toolset 输出端口 → 连接到 Agent 的 Tools 输入
Step 4. Tool Mode で Agent に接続する
カスタムコンポーネントを Tool Mode に切り替えると、Agent が自律的に呼び出せるツールになります。Input に tool_mode=True を設定すると、その入力がツールパラメーターとして公開されます。
Tool Mode の有効化
コンポーネントヘッダーのメニュー(⋮) → Tool Mode ON → Toolset 出力ポートが生成 → Agent の Tools 入力に接続
from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data


class WordCounter(Component):
    display_name = "Word Counter"
    # description: Agent가 이 Tool을 선택할지 판단하는 핵심 텍스트
    description = "주어진 텍스트의 단어 수와 글자 수를 세어 반환합니다"

    inputs = [
        StrInput(
            name="text",              # Agent에게 노출되는 파라미터명
            display_name="Text",
            info="분석할 텍스트",
            required=True,
            tool_mode=True,           # Tool Mode에서 이 Input을 도구 파라미터로 노출
        ),
    ]

    outputs = [
        Output(
            display_name="Count Result",
            name="count_words",       # Agent에게 보이는 Action 이름 (slug)
            method="count_words",
        ),
    ]

    def count_words(self) -> Data:
        words = len(self.text.split())
        chars = len(self.text)
        result = f"단어 수: {words}, 글자 수: {chars}"
        self.status = result
        return Data(data={"text": result, "words": words, "chars": chars})
name(slug)이 중요합니다
Output의 name은 Agent가 보는 Action 이름(slug)이 됩니다. 위 예시에서 name="count_words"로 설정하면 Agent의 Actions 목록에 COUNT_WORDS로 표시됩니다. Agent가 어떤 동작인지 직관적으로 이해할 수 있도록 명확한 snake_case 이름을 사용하세요.
TIP: description + name 모두 중요
description: Agent가 "이 Tool을 호출할지" 판단하는 근거
name (slug): Agent가 "어떤 Action을 실행할지" 식별하는 ID
둘 다 구체적이고 명확하게 작성하세요.
name (slug) matters
The Output's name becomes the Action name (slug) the Agent sees. Setting name="count_words" shows as COUNT_WORDS in the Agent's Actions list. Use clear snake_case names so the Agent understands what each action does.
TIP: Both description + name matter
description: How the Agent decides "whether to call this Tool"
name (slug): How the Agent identifies "which Action to execute"
Make both specific and clear.
name(slug)很重要
Output 的 name 会成为 Agent 看到的 Action 名称(slug)。设置 name="count_words" 后,在 Agent 的 Actions 列表中显示为 COUNT_WORDS。使用清晰的 snake_case 命名。
提示:description 和 name 都重要
description:Agent 判断"是否调用此工具"的依据
name(slug):Agent 识别"执行哪个 Action"的 ID
两者都要具体明确。
name(slug)が重要です
Output の name は Agent が見る Action 名(slug)になります。name="count_words" と設定すると、Agent の Actions リストに COUNT_WORDS と表示されます。Agent が何の動作かを直感的に理解できるよう、明確な snake_case の名前を使用してください。
TIP:description と name はどちらも重要
description:Agent が「このToolを呼び出すか」を判断する根拠
name(slug):Agent が「どの Action を実行するか」を識別する ID
どちらも具体的かつ明確に記述してください。
↑ Toolset → Agent Tools

Message vs Data 이해하기
Custom Component를 만들 때, 출력 타입으로 Message와 Data 중 하나를 선택합니다. 이 둘의 차이를 이해하는 것이 중요합니다.
Understanding Message vs Data
When building Custom Components, you choose between Message and Data as output types. Understanding the difference is important.
理解 Message 与 Data
创建自定义组件时,需要在 Message 和 Data 之间选择输出类型。理解两者的区别很重要。
Message と Data の理解
カスタムコンポーネントを作成する際、出力タイプとして Message と Data のどちらかを選択します。この違いを理解することが重要です。
| 구분 | Aspect | 区分 | 区分 | Message | Data | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 용도 | Purpose | 用途 | 用途 | 대화 메시지 전달 (채팅) | Chat message delivery | 传递对话消息(聊天) | 会話メッセージの配信(チャット) | 구조화된 데이터 전달 (범용) | Structured data passing (general) | 传递结构化数据(通用) | 構造化データの受け渡し(汎用) |
| 속성 | Properties | 属性 | 属性 | text, sender, sender_name, session_id |
data (dict), text_key |
||||||
| Chat Output | Chat Output | Chat Output | Chat Output | 직접 연결 가능 | Directly connectable | 可直接连接 | 直接接続可能 | 변환 필요 (Parse Data 등) | Needs conversion (Parse Data etc.) | 需要转换(Parse Data 等) | 変換が必要(Parse Data など) |
| 사용 시점 | When to use | 使用场景 | 使用タイミング | 사용자에게 보여줄 응답 | User-facing responses | 展示给用户的回复 | ユーザーに表示する応答 | 내부 데이터 가공/전달 | Internal data processing | 内部数据处理/传递 | 内部データの加工・受け渡し |
from langflow.schema.message import Message
from langflow.schema import Data

# Message: 채팅 응답용 (Chat Output에 직접 연결)
def chat_response(self) -> Message:
    return Message(text="안녕하세요! 반갑습니다.")

# Data: 구조화된 데이터 전달용 (내부 처리)
def process_data(self) -> Data:
    return Data(data={"name": "Langflow", "version": "1.0", "count": 42})
실습 과제 (5~10분)
Practice Exercise (5-10 min)
练习任务(5-10分钟)
実習課題(5〜10分)
- Custom Component를 새로 만들어 보세요: 두 개의 텍스트 입력을 받아 합치는 'Text Merger' 컴포넌트를 작성하세요.
- Create a new Custom Component: write a 'Text Merger' component that accepts two text inputs and concatenates them.
- 新建一个 Custom Component:编写一个接收两个文本输入并将其合并的"Text Merger"组件。
- Custom Component を新規作成してください:2つのテキスト入力を受け取って結合する「Text Merger」コンポーネントを作成しましょう。
- 만든 컴포넌트에 Tool Mode를 활성화하고 Agent에 연결해 보세요.
- Enable Tool Mode on the component you created and connect it to an Agent.
- 在创建的组件上启用 Tool Mode,并将其连接到 Agent。
- 作成したコンポーネントで Tool Mode を有効にし、Agent に接続してみましょう。
- Agent에게 '두 문장을 합쳐줘'라고 요청하여 Tool이 호출되는지 확인하세요.
- Ask the Agent to 'merge two sentences' and verify that the Tool gets invoked.
- 向 Agent 请求"合并两句话",确认 Tool 被正确调用。
- Agentに「2つの文を結合して」とリクエストし、Toolが呼び出されることを確認してください。
퀴즈
Quiz
测验
クイズ
Custom Component의 출력 타입인 Message와 Data의 차이점은 무엇인가요?
What is the difference between Message and Data output types in Custom Components?
Custom Component 中 Message 和 Data 输出类型有什么区别?
Custom Component の出力タイプ Message と Data の違いは何ですか?
정답 보기
Show Answer
查看答案
答えを見る
Message는 Chat Output으로 전달되어 Playground에 표시되는 대화형 텍스트입니다. Data는 구조화된 딕셔너리(key-value) 형태로, 다른 컴포넌트의 입력으로 전달하기에 적합합니다. Chat에 보여줄 때는 Message, 내부 데이터 전달에는 Data를 사용합니다.
Message is conversational text that can be sent to Chat Output and displayed in the Playground. Data is a structured dictionary (key-value) format, ideal for passing to other components as input. Use Message for chat display, Data for internal data passing.
Message 是对话文本,可发送到 Chat Output 并在 Playground 中显示。Data 是结构化的字典(键值对)格式,适合作为其他组件的输入。聊天显示用 Message,内部数据传递用 Data。
Message は Chat Output に送信して Playground に表示される対話テキストです。Data は構造化された辞書(key-value)形式で、他のコンポーネントの入力として渡すのに適しています。チャット表示には Message、内部データ受け渡しには Data を使います。
5. Custom Component로 pip install 하기
환경에 필요한 패키지가 없을 때, subprocess로 직접 설치합니다.
보안 주의
신뢰할 수 있는 패키지만 설치하세요. 프로덕션은 Docker 이미지에 사전 포함을 권장합니다.
5. pip install via Custom Component
Install packages directly via subprocess when needed.
Security Warning
Only install trusted packages. Pre-include in Docker for production.
5. 通过自定义组件 pip install
需要时通过 subprocess 直接安装包。
安全警告
仅安装可信的包。生产环境建议预装在 Docker 中。
5. カスタムコンポーネントで pip install する
環境に必要なパッケージがない場合、subprocess で直接インストールします。
セキュリティ注意
信頼できるパッケージのみインストールしてください。本番環境では Docker イメージへの事前組み込みを推奨します。
import subprocess, sys
from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data

class PipInstaller(Component):
    display_name = "Pip Installer"
    description = "Python 패키지를 설치합니다"
    inputs = [StrInput(name="package_name", display_name="Package Name", required=True)]
    outputs = [Output(display_name="Result", name="result", method="install_package")]

    def install_package(self) -> Data:
        try:
            r = subprocess.run([sys.executable, "-m", "pip", "install", self.package_name],
                               capture_output=True, text=True, timeout=120)
            ok = r.returncode == 0
            self.status = f"{'설치 완료' if ok else '설치 실패'}: {self.package_name}"
            return Data(data={"status": "success" if ok else "error", "output": r.stdout if ok else r.stderr})
        except subprocess.TimeoutExpired:
            return Data(data={"status": "timeout"})
Freeze를 반드시 켜두세요
pip install 컴포넌트는 실행 후 반드시 Freeze를 켜두세요. Flow가 Runtime으로 올라갔을 때 매번 pip install이 실행되면 불필요한 지연과 오류가 발생합니다. Freeze하면 이전 실행 결과를 캐싱하여 재실행을 방지합니다.
Always enable Freeze
After running the pip install component, always turn on Freeze. If this Flow runs in Runtime, pip install would execute every time — causing unnecessary delays and errors. Freeze caches the previous result and prevents re-execution.
务必开启 Freeze
运行 pip install 组件后,务必开启 Freeze。当 Flow 在 Runtime 中运行时,每次都执行 pip install 会导致不必要的延迟和错误。Freeze 会缓存之前的结果,防止重复执行。
必ず Freeze を有効にしてください
pip install コンポーネントを実行した後は、必ず Freeze をオンにしてください。Flow が Runtime として起動した際、毎回 pip install が実行されると不要な遅延やエラーが発生します。Freeze をオンにすると以前の実行結果がキャッシュされ、再実行を防ぎます。
설치된 패키지 목록 확인 (pip list)
Checking Installed Packages (pip list)
查看已安装的包列表 (pip list)
インストール済みパッケージ一覧確認 (pip list)
import subprocess, sys
from langflow.custom import Component
from langflow.io import StrInput, Output
from langflow.schema import Data

class PipListChecker(Component):
    display_name = "Pip List Checker"
    description = "설치된 패키지 목록을 확인합니다"
    inputs = [StrInput(name="filter_keyword", display_name="Filter", value="", advanced=True)]
    outputs = [Output(display_name="Package List", name="packages", method="list_packages")]

    def list_packages(self) -> Data:
        r = subprocess.run([sys.executable, "-m", "pip", "list", "--format=columns"],
                           capture_output=True, text=True)
        packages = r.stdout
        if self.filter_keyword:
            lines = packages.split("\n")
            filtered = [l for l in lines[2:] if self.filter_keyword.lower() in l.lower()]
            packages = "\n".join(lines[:2] + filtered)
            self.status = f"'{self.filter_keyword}': {len(filtered)}개"
        return Data(data={"packages": packages})
프로그래밍적 확인 (importlib)
Programmatic Check (importlib)
编程方式查看 (importlib)
プログラム的な確認 (importlib)
from importlib.metadata import distributions
for dist in distributions():
print(f"{dist.metadata['Name']} == {dist.version}")6. 간단한 Flow 사용법
Flow는 컴포넌트를 연결하여 구성한 AI 파이프라인입니다.
6. Basic Flow Usage
A Flow is an AI pipeline built by connecting components.
6. 简单 Flow 使用方法
Flow 是通过连接组件构建的 AI 管道。
6. 簡単な Flow の使い方
Flow はコンポーネントを繋いで構成した AI パイプラインです。
새 Flow 생성
+ New Flow → "Blank Flow" 선택
컴포넌트 배치
Chat Input, Prompt Template, OpenAI Compatible, Chat Output을 드래그
연결
Chat Input → Prompt → OpenAI Compatible → Chat Output
모델 서버 설정
OpenAI Compatible의 Base URL에 vLLM 주소 입력, 모델명 설정
Playground 테스트
우측 상단 Playground로 채팅 테스트
Playground 활성화 조건
Chat Output이 없으면 Playground 자체가 활성화되지 않습니다. Chat Input이 없으면 Playground는 있지만 채팅 입력 대신 Run Flow 버튼만 표시됩니다. Chat Input + Chat Output이 모두 있어야 대화형 채팅이 가능합니다.
Create New Flow
+ New Flow → Select "Blank Flow"
Place Components
Drag Chat Input, Prompt Template, OpenAI Compatible, Chat Output
Connect
Chat Input → Prompt → OpenAI Compatible → Chat Output
Configure Model
Set Base URL to vLLM server address and model name in OpenAI Compatible
Test in Playground
Click Playground at the top right to chat
Playground Activation
Without Chat Output, Playground won't activate at all. Without Chat Input, Playground exists but shows only a Run Flow button instead of a chat input. Both are needed for interactive chat.
创建新 Flow
+ New Flow → 选择 "Blank Flow"
放置组件
拖拽 Chat Input、Prompt Template、OpenAI Compatible、Chat Output
连接
Chat Input → Prompt → OpenAI Compatible → Chat Output
配置模型
在 OpenAI Compatible 中设置 vLLM 服务器的 Base URL 和模型名称
Playground 测试
点击右上角 Playground 进行聊天测试
Playground 激活条件
没有 Chat Output,Playground 不会激活。没有 Chat Input,Playground 存在但只显示 Run Flow 按钮而非聊天输入。两者都需要才能进行交互式聊天。
新しい Flow を作成
+ New Flow → "Blank Flow" を選択
コンポーネントを配置
Chat Input、Prompt Template、OpenAI Compatible、Chat Output をドラッグ
接続
Chat Input → Prompt → OpenAI Compatible → Chat Output
モデルサーバーの設定
OpenAI Compatible の Base URL に vLLM アドレスを入力し、モデル名を設定
Playground でテスト
右上の Playground でチャットテスト
Playground の有効化条件
Chat Output がないと Playground 自体が有効化されません。Chat Input がないと Playground は表示されますが、チャット入力の代わりに Run Flow ボタンのみ表示されます。対話型チャットには Chat Input と Chat Output の両方が必要です。
Settings: Global Variables
Flow에서 반복 사용하는 값(API Key, 서버 URL 등)을 Settings > Global Variables에서 한 곳에 등록하고, 모든 컴포넌트에서 참조할 수 있습니다.
Global Variable 등록
Settings > Global Variables > + Add New에서 이름(예: VLLM_BASE_URL)과 값을 입력합니다. Type을 Credential로 설정하면 값이 마스킹됩니다.
컴포넌트에서 사용
컴포넌트 입력 필드에서 지구본 아이콘을 클릭하면 등록된 Global Variable 목록이 표시됩니다. 원하는 변수를 선택하면 자동으로 바인딩됩니다.
TIP
API Key나 서버 URL을 컴포넌트마다 직접 입력하지 말고, Global Variable로 관리하세요. 값이 변경되면 한 곳만 수정하면 모든 Flow에 반영됩니다.
Settings: Global Variables
Register frequently used values (API keys, server URLs, etc.) in Settings > Global Variables and reference them across all components.
Register a Global Variable
Go to Settings > Global Variables > + Add New. Enter a name (e.g., VLLM_BASE_URL) and value. Set Type to Credential to mask the value.
Use in Components
Click the globe icon in any component input field to see registered Global Variables. Select one to auto-bind it.
TIP
Don't hard-code API keys or URLs in each component. Use Global Variables — when a value changes, update it once and it reflects everywhere.
Settings:Global Variables
在 Settings > Global Variables 中注册常用值(API 密钥、服务器 URL 等),在所有组件中引用。
注册 Global Variable
进入 Settings > Global Variables > + Add New,输入名称和值。将 Type 设为 Credential 可隐藏值。
在组件中使用
点击组件输入字段中的地球图标,选择已注册的 Global Variable 即可自动绑定。
提示
不要在每个组件中硬编码 API 密钥或 URL。使用 Global Variables——值变更时只需修改一处即可全部生效。
Settings:Global Variables
繰り返し使用する値(APIキー、サーバーURLなど)を Settings > Global Variables で一元登録し、全コンポーネントから参照できます。
Global Variable の登録
Settings > Global Variables > + Add New で名前(例:VLLM_BASE_URL)と値を入力。Type を Credential に設定すると値がマスキングされます。
コンポーネントでの使用
コンポーネントの入力フィールドで地球アイコンをクリックすると、登録済み Global Variable の一覧が表示されます。選択すると自動バインドされます。
TIP
APIキーやURLをコンポーネントごとに直接入力せず、Global Variable で管理しましょう。値が変更されても一箇所だけ修正すれば全 Flow に反映されます。


관리자 참고: Credential 타입
아래는 Langflow 관리자(플랫폼 엔지니어) 관점의 내용입니다. Global Variable의 Type을 Credential로 설정하면 값이 암호화되어 저장됩니다. 이때 서버의 LANGFLOW_SECRET_KEY 환경변수가 Fernet 포맷을 준수해야 합니다. Fernet 키가 설정되지 않거나 형식이 잘못되면 Credential 값의 암복호화에 실패합니다. 일반 사용자는 관리자에게 문의하세요.
플랫폼 엔지니어 Tip: API Key & Workers 설정
LANGFLOW_API_KEY를 OS 환경변수로 관리하려면 LANGFLOW_API_KEY_SOURCE=env로 설정합니다. 이렇게 하면 API Key를 코드나 설정 파일이 아닌 시스템 환경변수에서 읽어옵니다.
LANGFLOW_WORKERS의 기본값은 1입니다. Knowledge Base Ingestion 등 무거운 작업이 수행되는 동안 Worker가 하나뿐이면 health check 응답이 지연되어 503 Error가 발생할 수 있습니다. 쾌적한 운영을 위해 2코어 이상 환경에서 LANGFLOW_WORKERS=3 이상으로 설정하는 것을 권장합니다.
Admin Note: Credential Type
This is for Langflow administrators (platform engineers). Setting Type to Credential encrypts the value. The server's LANGFLOW_SECRET_KEY env var must follow the Fernet format. If missing or malformed, encryption/decryption will fail. Regular users should contact the admin.
Platform Engineer Tip: API Key & Workers
To manage LANGFLOW_API_KEY via OS environment variables, set LANGFLOW_API_KEY_SOURCE=env.
LANGFLOW_WORKERS defaults to 1. During heavy tasks like Knowledge Base Ingestion, a single worker can't respond to health checks in time, causing 503 errors. For smooth operation, set LANGFLOW_WORKERS=3 or higher on 2+ core machines.
管理员注意:Credential 类型
以下为 Langflow 管理员(基础设施团队)参考内容。Type 设为 Credential 会加密存储值。服务器的 LANGFLOW_SECRET_KEY 环境变量必须遵循 Fernet 格式。缺失或格式错误将导致加解密失败。普通用户请联系管理员。
平台工程师 Tip:API Key 和 Workers 设置
通过 OS 环境变量管理 LANGFLOW_API_KEY,设置 LANGFLOW_API_KEY_SOURCE=env。
LANGFLOW_WORKERS 默认值为 1。Knowledge Base Ingestion 等重任务期间,单个 Worker 无法及时响应健康检查,导致 503 错误。建议在 2 核以上环境设置 LANGFLOW_WORKERS=3 以上。
管理者向け:Credential タイプ
以下は Langflow 管理者(インフラ担当)向けの内容です。Type を Credential に設定すると値が暗号化されます。サーバーの LANGFLOW_SECRET_KEY 環境変数が Fernet フォーマットに準拠している必要があります。キーが未設定または形式が不正な場合、暗復号化に失敗します。一般ユーザーは管理者にお問い合わせください。
プラットフォームエンジニア Tip:API Key & Workers 設定
LANGFLOW_API_KEY を OS 環境変数で管理するには LANGFLOW_API_KEY_SOURCE=env を設定します。
LANGFLOW_WORKERS のデフォルトは 1 です。Knowledge Base Ingestion などの重い処理中、Worker が1つだとヘルスチェックに応答できず 503 エラーが発生します。快適な運用には 2コア以上で LANGFLOW_WORKERS=3 以上を推奨します。
Run Flow: 다른 Flow를 서브프로세스로 실행
Run Flow 컴포넌트는 현재 Flow 안에서 다른 Langflow Flow를 서브프로세스로 실행할 수 있는 기능입니다. 이를 통해 복잡한 파이프라인을 여러 개의 독립적인 Flow로 분리하고, 필요할 때 호출하는 모듈화된 설계가 가능합니다.
주요 활용 사례
- Flow 체이닝: 여러 Flow를 순차적으로 연결하여 복잡한 워크플로우를 구성
- 조건부 실행: 특정 조건에 따라 다른 Flow를 선택적으로 실행
- Agent 도구 통합: Run Flow를 Agent의 Tool로 연결하여, Agent가 상황에 맞는 Flow를 자율적으로 호출
Run Flow: Execute Another Flow as a Subprocess
The Run Flow component lets you run another Langflow Flow as a subprocess within your current Flow. This enables a modular design — split complex pipelines into independent Flows and invoke them as needed.
Key Use Cases
- Flow chaining: Connect multiple Flows sequentially for complex workflows
- Conditional execution: Selectively run different Flows based on conditions
- Agent tool integration: Attach Run Flow as an Agent Tool, letting the Agent autonomously invoke the right Flow
Run Flow:将其他 Flow 作为子进程执行
Run Flow 组件可以在当前 Flow 中将另一个 Langflow Flow 作为子进程运行。这实现了模块化设计——将复杂管道拆分为独立 Flow,按需调用。
主要使用场景
- Flow 链式调用:顺序连接多个 Flow 构建复杂工作流
- 条件执行:根据条件选择性运行不同 Flow
- Agent 工具集成:将 Run Flow 作为 Agent 工具,让 Agent 自主调用合适的 Flow
Run Flow:別の Flow をサブプロセスとして実行
Run Flow コンポーネントは、現在の Flow 内で別の Langflow Flow をサブプロセスとして実行できます。これにより複雑なパイプラインを独立した Flow に分割し、必要に応じて呼び出すモジュール化設計が可能です。
主な活用例
- Flow チェイニング:複数の Flow を順次接続して複雑なワークフローを構成
- 条件付き実行:特定条件に応じて異なる Flow を選択的に実行
- Agent ツール統合:Run Flow を Agent の Tool として接続し、Agent が状況に応じた Flow を自律的に呼び出し
↑ Agent Tools — Agent가 상황에 맞는 Flow를 자율 호출 autonomously invokes the right Flow 自主调用合适的 Flowが状況に合った Flow を自律呼び出し
| 파라미터 | Parameter | 参数 | パラメータ | 타입 | Type | 类型 | 型 | 설명 | Description | 说明 | 説明 |
|---|---|---|---|---|---|---|---|---|---|---|---|
flow_name_selected | Dropdown | 실행할 Flow 선택 | Select which Flow to run | 选择要执行的 Flow | 実行する Flow を選択 | ||||||
session_id | String | 서브플로우의 세션 ID (선택) | Custom session ID for subflow (optional) | 子流程的会话 ID(可选) | サブフローのセッション ID(任意) | ||||||
flow_tweak_data | Dictionary | Flow 동작 커스터마이징을 위한 Tweak 데이터 | Tweak data to customize Flow behavior | 用于自定义 Flow 行为的 Tweak 数据 | Flow 動作カスタマイズ用 Tweak データ | ||||||
run_outputs | List | 실행 결과 (JSON / Message / Table) | Execution results (JSON / Message / Table) | 执行结果(JSON / Message / Table) | 実行結果(JSON / Message / Table) |
TIP: 동적 필드 자동 생성
Run Flow에서 대상 Flow를 선택하면, 해당 Flow의 입력/출력 구조에 맞는 필드가 자동으로 생성됩니다. 별도로 매핑을 설정할 필요 없이 바로 데이터를 전달할 수 있습니다.
TIP: Auto-generated Dynamic Fields
When you select a target Flow in Run Flow, fields are automatically generated to match that Flow's input/output structure. No manual mapping needed — just pass data directly.
提示:动态字段自动生成
在 Run Flow 中选择目标 Flow 后,会自动生成匹配该 Flow 输入/输出结构的字段。无需手动映射,直接传递数据即可。
TIP:動的フィールドの自動生成
Run Flow で対象 Flow を選択すると、その Flow の入出力構造に合わせたフィールドが自動生成されます。手動でマッピングを設定する必要なく、そのままデータを渡せます。
Batch Run: LLM으로 Table 데이터를 일괄 처리
Batch Run 컴포넌트는 Table의 특정 텍스트 컬럼에 대해 LLM을 행(row) 단위로 일괄 실행합니다. CSV 파일이나 SpreadSheet에서 읽어온 대량의 데이터를 한 번에 LLM으로 처리할 때 유용합니다.
설정 방법
Batch Run: Process Table Data with LLM in Bulk
The Batch Run component runs a language model over each row of a text column in a Table. Ideal for bulk-processing large datasets from CSV files or SpreadSheets through an LLM.
Setup Steps
Batch Run:用 LLM 批量处理 Table 数据
Batch Run 组件对 Table 的特定文本列逐行运行 LLM。适用于通过 LLM 批量处理从 CSV 或 SpreadSheet 读取的大量数据。
设置方法
Batch Run:LLM で Table データを一括処理
Batch Run コンポーネントは Table の特定テキスト列に対して LLM を行単位で一括実行します。CSV や SpreadSheet から読み込んだ大量データを LLM で一度に処理する際に便利です。
設定方法
Language Model 연결
vLLM 또는 OpenAI Compatible 컴포넌트를 Batch Run의 Language model 포트(Fuchsia)에 연결합니다.
Table 데이터 연결
Read File(CSV)이나 SpreadSheet 등 Table 출력 컴포넌트를 DataFrame 포트(Pink)에 연결합니다.
Column Name 지정
LLM에 전달할 텍스트가 담긴 컬럼 이름을 지정합니다. (예: question, text)
System Message 설정 (선택)
모든 행에 공통으로 적용될 LLM 지시사항을 작성합니다. (예: "다음 텍스트를 한국어로 요약하세요")
결과 확인
Batch Results 출력을 Parser나 Chat Output에 연결하여 결과를 확인합니다.
Connect Language Model
Connect a vLLM or OpenAI Compatible component to the Language model port (Fuchsia).
Connect Table Data
Connect a Read File (CSV), SpreadSheet, or other Table output to the DataFrame port (Pink).
Specify Column Name
Set the column name containing the text to send to the LLM (e.g., question, text).
Set System Message (optional)
Write LLM instructions applied to every row (e.g., "Summarize the following text in English").
Check Results
Connect Batch Results output to a Parser or Chat Output to view results.
连接 Language Model
将 vLLM 或 OpenAI Compatible 组件连接到 Language model 端口(Fuchsia)。
连接 Table 数据
将 Read File(CSV)、SpreadSheet 等 Table 输出组件连接到 DataFrame 端口(Pink)。
指定 Column Name
设置包含要发送给 LLM 的文本的列名(例如:question、text)。
设置 System Message(可选)
编写应用于每行的 LLM 指令(例如:"请将以下文本翻译成中文")。
查看结果
将 Batch Results 输出连接到 Parser 或 Chat Output 查看结果。
Language Model を接続
vLLM または OpenAI Compatible コンポーネントを Language model ポート(Fuchsia)に接続します。
Table データを接続
Read File(CSV)や SpreadSheet などの Table 出力コンポーネントを DataFrame ポート(Pink)に接続します。
Column Name を指定
LLM に渡すテキストが含まれるカラム名を指定します(例:question、text)。
System Message の設定(任意)
全行に共通で適用される LLM 指示を記述します(例:「次のテキストを日本語で要約してください」)。
結果を確認
Batch Results 出力を Parser や Chat Output に接続して結果を確認します。
출력 Table 구조
Output Table Structure
输出 Table 结构
出力 Table 構造
| 컬럼 | Column | 列名 | カラム | 설명 | Description | 说明 | 説明 |
|---|---|---|---|---|---|---|---|
text_input | 원본 텍스트 (입력 컬럼의 값) | Original text from the input column | 原始文本(输入列的值) | 元のテキスト(入力カラムの値) | |||
model_response | LLM의 응답 결과 | LLM's response | LLM 的响应结果 | LLM の応答結果 | |||
batch_index | 처리 순서 (0부터 시작) | Processing order (0-indexed) | 处理顺序(从 0 开始) | 処理順序(0 始まり) | |||
metadata | 처리 메타데이터 (선택) | Processing metadata (optional) | 处理元数据(可选) | 処理メタデータ(任意) |
Parser와 함께 사용
Batch Run의 출력은 Table 형태입니다. Parser 컴포넌트에서 {text_input}, {model_response}, {batch_index} 등의 변수를 사용하여 원하는 형태로 결과를 포맷팅할 수 있습니다.
공식 문서 참조
자세한 내용은 Run Flow 문서 및 Batch Run 문서를 참조하세요.
Use with Parser
Batch Run output is in Table format. Use the Parser component with variables like {text_input}, {model_response}, and {batch_index} to format results as needed.
Official Docs
For details, see Run Flow docs and Batch Run docs.
配合 Parser 使用
Batch Run 的输出为 Table 格式。在 Parser 组件中使用 {text_input}、{model_response}、{batch_index} 等变量来格式化结果。
官方文档
详情请参阅 Run Flow 文档 和 Batch Run 文档。
Parser との併用
Batch Run の出力は Table 形式です。Parser コンポーネントで {text_input}、{model_response}、{batch_index} などの変数を使って結果をフォーマットできます。
公式ドキュメント参照
詳細は Run Flow ドキュメント と Batch Run ドキュメント をご参照ください。
퀴즈
Quiz
测验
クイズ
Playground가 활성화되려면 어떤 컴포넌트가 반드시 필요한가요?
Which component is required for the Playground to be activated?
要激活 Playground,必须有哪个组件?
Playground を有効にするには、どのコンポーネントが必ず必要ですか?
정답 보기
Show Answer
查看答案
答えを見る
Chat Output 컴포넌트가 있어야 Playground가 활성화됩니다. Chat Input이 없으면 Playground는 있지만 채팅 대신 Run Flow 버튼만 표시됩니다.
A Chat Output component is required for the Playground to be activated. Without a Chat Input, the Playground is still present but only shows a Run Flow button instead of a chat interface.
必须有 Chat Output 组件才能激活 Playground。如果没有 Chat Input,Playground 仍然存在,但只显示 Run Flow 按钮而不是聊天界面。
Chat Output コンポーネントがあることで Playground が有効になります。Chat Input がない場合、Playground は表示されますがチャットの代わりに Run Flow ボタンのみが表示されます。
실습 과제 (5~10분)
Practice Exercise (5-10 min)
练习任务(5-10分钟)
実習課題(5〜10分)
- Chat Input → Prompt Template → OpenAI Compatible → Chat Output 기본 Flow를 만들어 보세요.
- Build a basic Flow: Chat Input → Prompt Template → OpenAI Compatible → Chat Output.
- 创建基本 Flow:Chat Input → Prompt Template → OpenAI Compatible → Chat Output。
- 基本的な Flow を作成してください:Chat Input → Prompt Template → OpenAI Compatible → Chat Output。
- Prompt Template에 시스템 프롬프트를 작성하고, Playground에서 테스트하세요.
- Write a system prompt in the Prompt Template and test it in the Playground.
- 在 Prompt Template 中编写系统提示,并在 Playground 中进行测试。
- Prompt Template にシステムプロンプトを記述し、Playground でテストしてください。
- Global Variable로 vLLM Base URL을 등록하고 OpenAI Compatible 컴포넌트에서 참조해 보세요.
- Register the vLLM Base URL as a Global Variable and reference it from the OpenAI Compatible component.
- 将 vLLM Base URL 注册为 Global Variable,并在 OpenAI Compatible 组件中引用它。
- vLLM Base URL を Global Variable として登録し、OpenAI Compatible コンポーネントから参照してみましょう。
7. Agent 만들기 (Tool Mode)
Agent는 LLM이 도구를 자율적으로 선택하고 호출하여 작업을 수행합니다.
7. Building Agents (Tool Mode)
The Agent autonomously selects and invokes tools to accomplish tasks.
7. 创建 Agent(工具模式)
Agent 自主选择和调用工具执行任务。
7. Agent の作成(Tool Mode)
Agent は LLM がツールを自律的に選択・呼び出してタスクを実行します。
↑ Toolset → Agent Tools
Agent 추가
Agents > Agent를 캔버스에 드래그. 모델과 시스템 프롬프트 설정.
Tool 추가
Calculator, Python REPL, 또는 Custom Component 추가.
Tool Mode ON
컴포넌트 헤더 (⋮) → Tool Mode ON → Toolset 포트 생성
연결 및 테스트
Toolset → Agent Tools, Chat Input/Output 연결 후 Playground에서 테스트
설정 팁
- 시스템 프롬프트: Agent 역할과 사용 가능한 도구를 명확히 설명
- 모델: Function Calling 지원 모델 사용
- Tool description: 구체적으로 작성할수록 Agent가 정확히 선택합니다
Add Agent
Drag Agents > Agent. Configure model and system prompt.
Add Tools
Add Calculator, Python REPL, or Custom Components.
Tool Mode ON
Header (⋮) → Tool Mode ON → Toolset port appears
Connect & Test
Toolset → Agent Tools, connect Chat I/O, test in Playground
Tips
- System Prompt: Clearly describe Agent role and available tools
- Model: Use one that supports Function Calling
- Tool description: More specific = better tool selection
添加 Agent
拖拽 Agents > Agent。配置模型和系统提示词。
添加工具
添加 Calculator、Python REPL 或自定义组件。
Tool Mode ON
标题栏 (⋮) → 开启 Tool Mode → 出现 Toolset 端口
连接并测试
Toolset → Agent Tools,连接 Chat I/O,在 Playground 测试
配置技巧
- 系统提示词:清晰描述 Agent 角色和可用工具
- 模型:使用支持 Function Calling 的模型
- Tool description:描述越具体,Agent 选择越准确
Agent を追加
Agents > Agent をキャンバスにドラッグ。モデルとシステムプロンプトを設定。
Tool を追加
Calculator、Python REPL、またはカスタムコンポーネントを追加。
Tool Mode ON
コンポーネントヘッダー (⋮) → Tool Mode ON → Toolset ポートが生成
接続してテスト
Toolset → Agent Tools に接続し、Chat Input/Output を繋いで Playground でテスト
設定のヒント
- システムプロンプト:Agent の役割と使用可能なツールを明確に説明
- モデル:Function Calling をサポートするモデルを使用
- Tool description:具体的に書くほど Agent が正確に選択します
실습 과제 (5~10분)
Practice Exercise (5-10 min)
练习任务(5-10分钟)
実習課題(5〜10分)
- Agent 컴포넌트를 추가하고, Calculator Tool과 Python REPL Tool을 연결하세요.
- Add an Agent component and connect both a Calculator Tool and a Python REPL Tool to it.
- 添加 Agent 组件,并将 Calculator Tool 和 Python REPL Tool 连接到它。
- Agent コンポーネントを追加し、Calculator Tool と Python REPL Tool を接続してください。
- Agent에게 '123 * 456의 결과를 알려줘'라고 요청하여 Calculator Tool이 호출되는지 확인하세요.
- Ask the Agent 'What is 123 * 456?' and verify that the Calculator Tool is invoked.
- 向 Agent 请求"告诉我 123 * 456 的结果",确认 Calculator Tool 被调用。
- Agentに「123 * 456の結果を教えて」とリクエストし、Calculator Toolが呼び出されることを確認してください。
- Custom Component를 하나 더 만들어 Tool Mode로 Agent에 추가해 보세요.
- Create one more Custom Component, enable Tool Mode, and add it to the Agent.
- 再创建一个 Custom Component,启用 Tool Mode 并添加到 Agent。
- Custom Component をもう1つ作成し、Tool Mode を有効にして Agent に追加してみましょう。
퀴즈
Quiz
测验
クイズ
Agent가 Tool을 호출하지 않을 때, 가장 먼저 확인해야 할 것은 무엇인가요?
When an Agent doesn't call a Tool, what should you check first?
当 Agent 不调用 Tool 时,应该首先检查什么?
Agent が Tool を呼び出さない場合、最初に確認すべきことは何ですか?
정답 보기
Show Answer
查看答案
答えを見る
Tool의 description을 확인하세요. Agent는 description을 읽고 어떤 Tool을 호출할지 판단합니다. description이 모호하거나 부족하면 Agent가 적절한 Tool을 선택하지 못합니다. "이 도구는 ~할 때 사용합니다"처럼 구체적으로 작성하세요.
Check the Tool's description. The Agent reads descriptions to decide which Tool to call. If the description is vague or insufficient, the Agent cannot select the right Tool. Write specifically: "Use this tool when ~".
检查 Tool 的 description。Agent 通过阅读 description 决定调用哪个 Tool。如果描述模糊或不足,Agent 无法选择正确的 Tool。具体描述:"此工具用于~"。
Tool の description を確認してください。Agent は description を読んでどの Tool を呼び出すか判断します。description が曖昧だと Agent は適切な Tool を選択できません。「このツールは〜するときに使います」のように具体的に記述してください。
8. API Access
완성한 Flow는 HTTP API로 외부에 노출할 수 있습니다. 엔드포인트를 확인하려면 Share > API Access를 여세요. 현재 두 가지 API가 제공되며, 목적에 따라 고르면 됩니다.
8. API Access
A finished flow can be exposed over HTTP. Open Share > API Access to find the endpoints. Two APIs are available today; pick based on what you need.
8. API 访问
完成的 Flow 可通过 HTTP API 对外暴露。打开 Share > API Access 查看端点。目前提供两种 API,可按用途选择。
8. API アクセス
完成した Flow は HTTP API として外部に公開できます。エンドポイントは Share > API Access で確認します。現在2種類の API が提供されており、目的に応じて選べます。
| 이런 경우라면If you want to…若属于以下情况こんな場合は | 선택Use选择選択 |
|---|---|
| 기존 OpenAI SDK 코드를 그대로 쓰고 싶다 / 다른 앱에서 LLM처럼 부르고 싶다Reuse existing OpenAI SDK code, or call the flow like an LLM from another app希望沿用现有 OpenAI SDK 代码,或从其他应用像调用 LLM 一样调用既存の OpenAI SDK コードをそのまま使いたい / 他アプリから LLM のように呼びたい | 8-1. /api/v1/responses |
| 컴포넌트 파라미터를 호출 시점에 덮어쓰고 싶다 / 오래 걸리는 작업을 백그라운드로 돌리고 싶다Override component parameters per call, or run long jobs in the background希望在调用时覆盖组件参数,或将耗时任务放到后台运行コンポーネントのパラメータを呼び出し時に上書きしたい / 長時間の処理をバックグラウンドで回したい | 8-2. /api/v2/workflows1.11 |
8-1. OpenAI 호환 API
Flow를 OpenAI 호환 API로 노출합니다. Flow ID를 model 이름처럼 사용하는 것이 핵심입니다.
8-1. OpenAI-Compatible API
Exposes the flow as an OpenAI-compatible API. The trick is that the Flow ID acts as the model name.
8-1. OpenAI 兼容 API
将 Flow 作为 OpenAI 兼容 API 暴露。关键在于将 Flow ID 用作 model 名称。
8-1. OpenAI 互換 API
Flow を OpenAI 互換 API として公開します。Flow ID を model 名として使う点がポイントです。
| Endpoint | POST {LANGFLOW_URL}/api/v1/responses |
| Auth | x-api-key header |
| Model | Flow ID |
1) requests 호출
1) requests call
1) requests 调用
1) requests での呼び出し
import requests
response = requests.post(
    "http://your-langflow-server:7860/api/v1/responses",
    headers={"x-api-key": "YOUR_API_KEY", "Content-Type": "application/json"},
    json={"model": "YOUR_FLOW_ID", "input": "안녕하세요!"},
)
print(response.json())
2) OpenAI SDK 호환
2) OpenAI SDK compatible
2) OpenAI SDK 兼容
2) OpenAI SDK 互換
from openai import OpenAI
client = OpenAI(
    base_url="http://your-langflow-server:7860/api/v1",
    api_key="YOUR_API_KEY",
    default_headers={"x-api-key": "YOUR_API_KEY"},
)
response = client.responses.create(model="YOUR_FLOW_ID", input="설명해주세요.")
print(response.output_text)
3) 스트리밍
3) Streaming
3) 流式
3) ストリーミング
stream = client.responses.create(model="YOUR_FLOW_ID", input="장점을 알려주세요.", stream=True)
for event in stream:
    print(event)
4) 멀티턴 대화
4) Multi-turn
4) 多轮对话
4) マルチターン会話
r1 = client.responses.create(model="YOUR_FLOW_ID", input="안녕하세요!")
r2 = client.responses.create(model="YOUR_FLOW_ID", input="방금 뭐라고 했죠?", previous_response_id=r1.id)
TIP
이 API로 Langflow Flow를 웹 앱, 모바일 앱 등에서 LLM API처럼 호출할 수 있습니다. 기존 OpenAI SDK 코드에서 base_url만 변경하면 됩니다.
TIP
Call your Langflow Flow like a standard LLM API from any app. Just change base_url in existing OpenAI SDK code.
提示
可从任何应用像调用标准 LLM API 一样调用 Langflow Flow。只需更改 OpenAI SDK 中的 base_url。
TIP
この API で Langflow Flow をウェブアプリやモバイルアプリなどから LLM API のように呼び出せます。既存の OpenAI SDK コードの base_url を変更するだけです。
8-2. Workflow API v21.11
1.11에서 추가된 새 API입니다 (Beta). OpenAI 호환성을 버리는 대신, Flow를 "실행"하는 데 필요한 제어권을 더 많이 줍니다 — 호출할 때마다 컴포넌트 설정을 바꾸거나, 오래 걸리는 작업을 백그라운드 잡으로 던져 놓을 수 있습니다.
8-2. Workflow API v21.11
A new API added in 1.11 (Beta). It gives up OpenAI compatibility in exchange for more control over how the flow runs — override component settings per call, or hand long-running work off as a background job.
8-2. Workflow API v21.11
1.11 新增的 API(Beta)。它舍弃了 OpenAI 兼容性,换来对 Flow"运行方式"更强的控制权 — 可在每次调用时覆盖组件设置,或将耗时任务作为后台作业提交。
8-2. Workflow API v21.11
1.11 で追加された新しい API です(Beta)。OpenAI 互換性を手放す代わりに、Flow の「実行」に対するより多くの制御を提供します — 呼び出しごとにコンポーネント設定を上書きしたり、長時間の処理をバックグラウンドジョブとして投げたりできます。
| Endpoint | POST {LANGFLOW_URL}/api/v2/workflows |
| Auth | x-api-key header |
| Body | flow_id, mode, input_value, tweaks, globals |
3가지 실행 모드
sync— 인라인 실행. 완료까지 기다렸다가WorkflowExecutionResponse를 한 번에 받습니다.stream— SSE(Server-Sent Events)로 진행 상황을 실시간 수신합니다.background— 큐에 적재하고 job 객체를 즉시 반환합니다. 이후 폴링으로 결과를 확인합니다.
주요 요청 필드
tweaks— 컴포넌트별 파라미터를 호출 시점에 덮어씁니다. Flow를 고치지 않고 모델명이나 Temperature만 바꿔 호출할 때 유용합니다.globals— 요청 스코프 변수 (sync모드 전용).
스트리밍 프로토콜 (stream_protocol)
langflow(기본값) — Langflow 내부 EventManager 이벤트:token,add_message,end_vertex등. Flow 내부 동작까지 들여다볼 때.agui— AG-UI 프로토콜:RUN_STARTED,TEXT_MESSAGE_*,TOOL_CALL_*등. 클라이언트가 에이전트 생애주기 이벤트를 기대할 때.
Three execution modes
sync— runs inline. Waits for completion and returns a singleWorkflowExecutionResponse.stream— streams progress in real time over SSE (Server-Sent Events).background— queues the run and returns a job object immediately; poll for the result afterwards.
Key request fields
tweaks— overrides per-component parameters at call time. Handy for changing a model name or temperature without editing the flow.globals— request-scoped variables (syncmode only).
Streaming protocols (stream_protocol)
langflow(default) — Langflow's internal EventManager events:token,add_message,end_vertex, etc. Use it when you want visibility into the flow's internals.agui— the AG-UI protocol:RUN_STARTED,TEXT_MESSAGE_*,TOOL_CALL_*, etc. Use it when your client expects agent lifecycle events.
三种执行模式
sync— 内联执行。等待完成后一次性返回WorkflowExecutionResponse。stream— 通过 SSE(Server-Sent Events)实时接收进度。background— 写入队列并立即返回 job 对象,随后通过轮询获取结果。
主要请求字段
tweaks— 在调用时覆盖各组件的参数。无需修改 Flow 即可更改模型名或 Temperature。globals— 请求作用域变量(仅sync模式)。
流式协议(stream_protocol)
langflow(默认)— Langflow 内部 EventManager 事件:token、add_message、end_vertex等。适合需要观察 Flow 内部动作时。agui— AG-UI 协议:RUN_STARTED、TEXT_MESSAGE_*、TOOL_CALL_*等。适合客户端期待代理生命周期事件时。
3つの実行モード
sync— インライン実行。完了まで待ってWorkflowExecutionResponseを一度に受け取ります。stream— SSE(Server-Sent Events)で進捗をリアルタイムに受信します。background— キューに投入し job オブジェクトを即座に返します。以降はポーリングで結果を確認します。
主なリクエストフィールド
tweaks— コンポーネントごとのパラメータを呼び出し時に上書きします。Flow を編集せずモデル名や Temperature だけ変えたい場合に便利です。globals— リクエストスコープの変数(syncモード専用)。
ストリーミングプロトコル(stream_protocol)
langflow(既定)— Langflow 内部の EventManager イベント:token、add_message、end_vertexなど。Flow の内部動作まで見たい場合に。agui— AG-UI プロトコル:RUN_STARTED、TEXT_MESSAGE_*、TOOL_CALL_*など。クライアントがエージェントのライフサイクルイベントを期待する場合に。
1) sync 모드 — tweaks로 파라미터 덮어쓰기
1) sync mode — overriding parameters with tweaks
1) sync 模式 — 用 tweaks 覆盖参数
1) sync モード — tweaks でパラメータを上書き
import requests

BASE = "http://your-langflow-server:7860"
HEADERS = {"x-api-key": "YOUR_API_KEY", "Content-Type": "application/json"}

response = requests.post(
    f"{BASE}/api/v2/workflows",
    headers=HEADERS,
    json={
        "flow_id": "YOUR_FLOW_ID",
        "mode": "sync",
        "input_value": "3분기 실적을 요약해줘",
        # Flow를 수정하지 않고 이번 호출에만 다른 설정을 적용
        "tweaks": {
            "LanguageModel-abc12": {"temperature": 0.2},
        },
    },
    timeout=120,
)
response.raise_for_status()
print(response.json())
2) background 모드 — 오래 걸리는 작업 폴링
2) background mode — polling a long-running job
2) background 模式 — 轮询耗时任务
2) background モード — 長時間処理のポーリング
import time
import requests

BASE = "http://your-langflow-server:7860"
HEADERS = {"x-api-key": "YOUR_API_KEY", "Content-Type": "application/json"}

# 잡을 큐에 넣고 즉시 반환받는다
job = requests.post(
    f"{BASE}/api/v2/workflows",
    headers=HEADERS,
    json={
        "flow_id": "YOUR_FLOW_ID",
        "mode": "background",
        "input_value": "전체 로그를 분석해줘",
    },
    timeout=30,
).json()

job_id = job["id"]

# 완료될 때까지 폴링 (간격을 두어 서버 부하를 피한다)
while True:
    status = requests.get(
        f"{BASE}/api/v2/workflows/{job_id}", headers=HEADERS, timeout=30
    ).json()
    if status["status"] in ("completed", "failed"):
        break
    time.sleep(3)

print(status)
1.10에서 v2를 쓰고 있었다면
Workflow API v2의 요청 스키마가 1.10.x와 1.11.x 사이에 변경되었습니다. 1.10 기준으로 작성한 클라이언트 코드는 그대로 동작하지 않으므로, 업그레이드 시 요청 본문을 새 스키마에 맞춰야 합니다. 반면 /api/v1/responses를 쓰는 코드는 영향을 받지 않습니다.
Beta 단계
Workflow API v2는 아직 Beta입니다. 스키마가 또 바뀔 수 있으므로, 사내 시스템에 깊게 연동할 때는 릴리스 노트를 함께 추적하시길 권합니다. 안정성이 우선이라면 8-1의 /api/v1/responses가 더 안전한 선택입니다.
If you were already using v2 on 1.10
The Workflow API v2 request schema changed between 1.10.x and 1.11.x. Client code written against 1.10 will not work unchanged — align your request body with the new schema when you upgrade. Code using /api/v1/responses is unaffected.
Still Beta
Workflow API v2 is in Beta, and the schema may shift again. If you're integrating it deeply into internal systems, track the release notes alongside it. When stability matters most, /api/v1/responses from 8-1 is the safer bet.
若您在 1.10 上已使用 v2
Workflow API v2 的请求结构在 1.10.x 与 1.11.x 之间已变更。基于 1.10 编写的客户端代码无法原样运行,升级时需将请求体调整为新结构。使用 /api/v1/responses 的代码则不受影响。
仍处于 Beta
Workflow API v2 尚处于 Beta,结构可能再次变动。若要深度集成到内部系统,建议同时跟踪发布说明。若以稳定性优先,8-1 的 /api/v1/responses 是更稳妥的选择。
1.10 で v2 を使っていた場合
Workflow API v2 のリクエストスキーマが 1.10.x と 1.11.x の間で変更されました。1.10 基準で書いたクライアントコードはそのままでは動作しないため、アップグレード時にリクエストボディを新スキーマに合わせる必要があります。/api/v1/responses を使うコードは影響を受けません。
まだ Beta
Workflow API v2 は Beta 段階で、スキーマが再び変わる可能性があります。社内システムへ深く統合する場合はリリースノートも併せて追跡することをお勧めします。安定性を優先するなら 8-1 の /api/v1/responses がより安全な選択です。
Settings: Langflow API Keys
외부 시스템에서 Langflow Flow를 호출하려면 API Key가 필요합니다. Settings > Langflow API Keys에서 관리합니다.
API Key 생성
Settings > Langflow API Keys > + Add New를 클릭하여 새 키를 생성합니다. 키 이름을 지정하여 용도를 구분할 수 있습니다.
API 호출 시 사용
생성된 키를 x-api-key 헤더에 포함하여 /api/v1/responses 엔드포인트를 호출합니다.
API Key 보안
생성된 API Key는 한 번만 표시됩니다. 반드시 안전한 곳에 보관하세요. 유출이 의심되면 즉시 삭제하고 새로 생성합니다.
Settings: Langflow API Keys
To call Langflow Flows from external systems, you need an API Key. Manage them at Settings > Langflow API Keys.
Create API Key
Click Settings > Langflow API Keys > + Add New to generate a new key. Name it to distinguish its purpose.
Use in API Calls
Include the generated key in the x-api-key header when calling the /api/v1/responses endpoint.
API Key Security
Generated API Keys are shown only once. Store them securely. If compromised, delete immediately and regenerate.
Settings:Langflow API Keys
从外部系统调用 Langflow Flow 需要 API Key。在 Settings > Langflow API Keys 中管理。
创建 API Key
点击 Settings > Langflow API Keys > + Add New 生成新密钥。命名以区分用途。
在 API 调用中使用
将生成的密钥包含在 x-api-key 头中,调用 /api/v1/responses 端点。
API Key 安全
生成的 API Key 仅显示一次,请妥善保管。如有泄露嫌疑,立即删除并重新生成。
Settings:Langflow API Keys
外部システムから Langflow Flow を呼び出すには API Key が必要です。Settings > Langflow API Keys で管理します。
API Key の生成
Settings > Langflow API Keys > + Add New をクリックして新しいキーを生成します。名前を付けて用途を区別できます。
API 呼び出しで使用
生成されたキーを x-api-key ヘッダーに含めて /api/v1/responses エンドポイントを呼び出します。
API Key セキュリティ
生成された API Key は一度だけ表示されます。安全な場所に保管してください。漏洩の疑いがある場合は即座に削除して再生成します。


퀴즈
Quiz
测验
クイズ
Langflow의 OpenAI 호환 API에서 인증은 어떤 방식을 사용하나요?
What authentication method does Langflow's OpenAI-compatible API use?
Langflow 的 OpenAI 兼容 API 使用哪种认证方式?
Langflow の OpenAI 互換 API ではどの認証方式を使用しますか?
정답 보기
Show Answer
查看答案
答えを見る
x-api-key 헤더를 사용합니다. Bearer 토큰이 아닌 점에 주의하세요. API Key는 Settings > Langflow API Keys에서 생성합니다.
It uses the x-api-key header. Note that it is not a Bearer token. API Keys are generated under Settings > Langflow API Keys.
使用 x-api-key 请求头。请注意,不是 Bearer token。API Key 在 Settings > Langflow API Keys 中生成。
x-api-key ヘッダーを使用します。Bearer トークンではない点に注意してください。API Key は Settings > Langflow API Keys で生成します。
9. RAG Pipeline 구축하기
RAG(Retrieval-Augmented Generation)는 LLM이 외부 문서를 검색(Retrieval)한 후 그 내용을 바탕으로 답변을 생성(Generation)하는 패턴입니다. 폐쇄망(Air-gapped) 내 사내 문서를 LLM이 참고하도록 만들 수 있어 실무에서 가장 많이 사용됩니다.
RAG가 필요한 이유
- LLM은 학습 데이터에 없는 사내 문서, 매뉴얼, 규정을 모름
- RAG로 관련 문서를 검색하여 LLM에 컨텍스트로 제공
- 할루시네이션(거짓 정보 생성)을 크게 줄일 수 있음
RAG Flow 구조
9. Building a RAG Pipeline
RAG (Retrieval-Augmented Generation) is a pattern where the LLM retrieves external documents first, then generates answers based on that content. Essential for making LLMs reference internal documents in air-gapped environments.
Why RAG?
- LLMs don't know your internal docs, manuals, or policies
- RAG retrieves relevant docs and provides them as context to the LLM
- Significantly reduces hallucinations
RAG Flow Structure
9. 构建 RAG 管道
RAG(检索增强生成)是 LLM 先检索外部文档,再基于内容生成回答的模式。在封闭网络中让 LLM 参考内部文档的必备方案。
为什么需要 RAG?
- LLM 不了解内部文档、手册、规章
- RAG 检索相关文档并作为上下文提供给 LLM
- 显著减少幻觉(生成虚假信息)
RAG Flow 结构
9. RAG パイプラインの構築
RAG(Retrieval-Augmented Generation)は LLM が外部ドキュメントを検索(Retrieval)した後、その内容を基に回答を生成(Generation)するパターンです。閉域網内の社内ドキュメントを LLM が参照できるようにする方法として最も実務で活用されています。
RAG が必要な理由
- LLM は学習データにない社内文書・マニュアル・規程を知らない
- RAG で関連文書を検索し、LLM にコンテキストとして提供
- ハルシネーション(誤情報の生成)を大幅に削減できる
RAG Flow の構造
Indexing (문서 저장)Indexing (Store Documents)索引(文档存储)インデクシング(文書保存)
Querying (검색 + 응답)Querying (Retrieve + Respond)查询(检索 + 回答)クエリ(検索 + 応答)
단계별 구축
Phase 1: 문서 인덱싱
문서 로드
File Loader 컴포넌트로 PDF, TXT, DOCX 등의 문서를 로드합니다.
텍스트 분할
Text Splitter로 문서를 적절한 크기의 청크(chunk)로 나눕니다. 일반적으로 500~1000자, 100~200자 overlap을 권장합니다.
임베딩 생성
Embeddings 컴포넌트(HuggingFace 또는 OpenAI Compatible)로 각 청크를 벡터로 변환합니다.
벡터 저장
Vector Store(Milvus, OpenSearch, PostgreSQL 등)에 벡터를 저장합니다.
Phase 2: 검색 및 응답
사용자 질문 → 유사 문서 검색
사용자 질문을 동일한 Embedding 모델로 벡터화한 후, Vector Store에서 유사도 검색으로 관련 청크를 가져옵니다.
프롬프트에 컨텍스트 삽입
검색된 문서 청크를 Prompt Template의 {context} 변수에 삽입합니다.
LLM이 컨텍스트 기반 응답 생성
LLM은 제공된 컨텍스트를 바탕으로 정확한 답변을 생성합니다.
RAG 프롬프트 예시
Step-by-Step Build
Phase 1: Document Indexing
Load Documents
Use File Loader to load PDF, TXT, DOCX files.
Split Text
Text Splitter divides documents into chunks. Recommended: 500-1000 chars, 100-200 char overlap.
Generate Embeddings
Embeddings component (HuggingFace or OpenAI Compatible) converts each chunk to a vector.
Store Vectors
Save vectors to a Vector Store (Milvus, OpenSearch, PostgreSQL, etc.).
Phase 2: Retrieval & Response
Query → Similar Document Search
Vectorize the user's question with the same Embedding model, then similarity search the Vector Store.
Inject Context into Prompt
Insert retrieved chunks into the Prompt Template's {context} variable.
LLM Generates Context-Based Response
The LLM generates an accurate answer based on the provided context.
RAG Prompt Example
分步构建
Phase 1:文档索引
加载文档
使用 File Loader 加载 PDF、TXT、DOCX 等文件。
文本分割
Text Splitter 将文档分成适当大小的块。建议:500-1000字符,100-200字符重叠。
生成嵌入
Embeddings 组件将每个块转换为向量。
存储向量
将向量保存到 Vector Store(Milvus、OpenSearch、PostgreSQL 等)。
Phase 2:检索与回答
查询 → 相似文档检索
用相同的 Embedding 模型向量化用户问题,在 Vector Store 中进行相似度搜索。
注入上下文到提示词
将检索到的文档块插入 Prompt Template 的 {context} 变量中。
LLM 基于上下文生成回答
LLM 基于提供的上下文生成准确的回答。
RAG 提示词示例
ステップごとの構築
Phase 1:文書インデクシング
文書の読み込み
File Loader コンポーネントで PDF、TXT、DOCX などの文書を読み込みます。
テキストの分割
Text Splitter で文書を適切なサイズのチャンクに分割します。一般的に 500〜1000 文字、100〜200 文字のオーバーラップを推奨します。
埋め込みの生成
Embeddings コンポーネント(HuggingFace または OpenAI Compatible)で各チャンクをベクトルに変換します。
ベクトルの保存
Vector Store(Milvus、OpenSearch、PostgreSQL など)にベクトルを保存します。
Phase 2:検索と応答
ユーザーの質問 → 類似文書の検索
ユーザーの質問を同じ Embedding モデルでベクトル化し、Vector Store で類似度検索を行い関連チャンクを取得します。
プロンプトへのコンテキスト挿入
検索された文書チャンクを Prompt Template の {context} 変数に挿入します。
LLM がコンテキストに基づいて応答を生成
LLM は提供されたコンテキストを基に正確な回答を生成します。
RAG プロンプト例
아래 참고 문서를 바탕으로 사용자의 질문에 답변해주세요.
참고 문서에 없는 내용은 "해당 정보를 찾을 수 없습니다"라고 답변하세요.

[참고 문서]
{context}

[사용자 질문]
{question}
TIP: 청크 크기 조절
청크가 너무 작으면 맥락이 부족하고, 너무 크면 검색 정확도가 떨어집니다. 문서 특성에 맞게 chunk_size와 chunk_overlap을 실험해보세요.
TIP: Chunk size tuning
Too small = missing context. Too large = lower retrieval accuracy. Experiment with chunk_size and chunk_overlap for your document type.
提示:调整块大小
太小缺乏上下文,太大降低检索精度。根据文档特点实验 chunk_size 和 chunk_overlap。
TIP:チャンクサイズの調整
チャンクが小さすぎると文脈が不足し、大きすぎると検索精度が低下します。文書の特性に合わせて chunk_size と chunk_overlap を試してみてください。
실습 과제 (5~10분)
Practice Exercise (5-10 min)
练习任务(5-10分钟)
実習課題(5〜10分)
- Knowledge 탭에서 새 컬렉션을 만들고 문서를 1~2개 업로드하세요.
- In the Knowledge tab, create a new collection and upload 1–2 documents.
- 在 Knowledge 标签页中新建一个集合,并上传 1~2 个文档。
- Knowledge タブで新しいコレクションを作成し、ドキュメントを1〜2件アップロードしてください。
- Flow에서 Chat Input → Knowledge → Prompt Template → LLM → Chat Output을 연결하세요.
- In the Flow, connect Chat Input → Knowledge → Prompt Template → LLM → Chat Output.
- 在 Flow 中连接 Chat Input → Knowledge → Prompt Template → LLM → Chat Output。
- Flow で Chat Input → Knowledge → Prompt Template → LLM → Chat Output を接続してください。
- 업로드한 문서 내용에 대해 질문하여 RAG가 동작하는지 확인하세요.
- Ask a question about the content of the uploaded documents and verify that RAG is working correctly.
- 针对上传文档的内容进行提问,确认 RAG 正常运作。
- アップロードしたドキュメントの内容について質問し、RAG が正しく動作することを確認してください。
퀴즈
Quiz
测验
クイズ
RAG에서 Chunk Size를 너무 크게 설정하면 어떤 문제가 발생하나요?
What problem occurs if you set the Chunk Size too large in RAG?
在 RAG 中将 Chunk Size 设置得太大会出现什么问题?
RAG で Chunk Size を大きくしすぎるとどんな問題が起きますか?
정답 보기
Show Answer
查看答案
答えを見る
Chunk가 너무 크면 관련 없는 내용이 함께 포함되어 검색 정확도가 떨어집니다. 반대로 너무 작으면 문맥이 끊겨서 의미를 파악하기 어렵습니다. 일반적으로 500~1000 토큰이 권장되며, Knowledge의 Chunk 미리보기 기능으로 적절한 크기를 테스트할 수 있습니다.
Too-large chunks include irrelevant content, reducing search accuracy. Too-small chunks lose context. Generally 500-1000 tokens is recommended. Use Knowledge's chunk preview feature to test appropriate sizes.
Chunk 太大会包含不相关内容,降低检索精度。太小则丢失上下文。通常推荐 500-1000 个 Token。可使用 Knowledge 的 Chunk 预览功能测试合适大小。
Chunk が大きすぎると関連のない内容が含まれ、検索精度が低下します。小さすぎると文脈が切れます。一般的に 500〜1000 トークンが推奨されます。Knowledge の Chunk プレビュー機能で適切なサイズをテストできます。
10. 실전 Tips & 트러블슈팅
Trace (Flow Activity) — 네이티브 Observability
Phoenix 같은 외부 Tracing 도구 없이도, Langflow 1.8+부터 Flow Activity에서 실행 과정을 네이티브로 추적할 수 있습니다.
- Flow Activity 패널: Flow 실행 후 각 컴포넌트의 입력/출력, 실행 시간, 상태를 단계별로 확인
- 에러 추적: 어떤 컴포넌트에서 실패했는지, 어떤 에러가 발생했는지 즉시 파악
- 토큰 사용량: LLM 호출 시 사용된 토큰 수와 비용 확인
- 실행 이력: 과거 실행 결과를 저장하여 비교/분석 가능
TIP
Flow가 예상대로 동작하지 않을 때, Flow Activity를 먼저 확인하세요. 각 컴포넌트의 입출력을 추적하면 문제 원인을 빠르게 찾을 수 있습니다. 별도의 외부 도구 설치 없이 Langflow 내에서 바로 가능합니다.
Trace (Flow Activity) — Native Observability
Since Langflow 1.8+, Flow Activity provides native execution tracing without external tools like Phoenix.
- Flow Activity panel: View each component's input/output, execution time, and status step by step
- Error tracking: Instantly identify which component failed and what error occurred
- Token usage: Check token counts and costs for LLM calls
- Execution history: Past runs are saved for comparison and analysis
TIP
When a Flow doesn't behave as expected, check Flow Activity first. Tracing each component's I/O helps pinpoint issues fast — no external tool installation needed.
Trace(Flow Activity)— 原生可观测性
从 Langflow 1.8+ 起,Flow Activity 无需 Phoenix 等外部工具即可原生追踪执行过程。
- Flow Activity 面板:逐步查看每个组件的输入/输出、执行时间和状态
- 错误追踪:即时识别哪个组件失败及错误原因
- Token 用量:查看 LLM 调用的 Token 数量和成本
- 执行历史:保存过去的运行结果用于比较和分析
提示
Flow 未按预期工作时,先检查 Flow Activity。追踪每个组件的输入/输出可快速定位问题——无需安装外部工具。
Trace(Flow Activity)— ネイティブ Observability
Langflow 1.8+ から、Phoenix などの外部ツールなしで Flow Activity でネイティブに実行過程を追跡できます。
- Flow Activity パネル:各コンポーネントの入出力、実行時間、ステータスをステップごとに確認
- エラー追跡:どのコンポーネントで失敗したか、どんなエラーが発生したか即座に把握
- トークン使用量:LLM 呼び出しで使用されたトークン数とコストを確認
- 実行履歴:過去の実行結果を保存して比較・分析可能
TIP
Flow が期待通りに動作しない時は、まず Flow Activity を確認しましょう。各コンポーネントの入出力を追跡すれば問題原因を素早く特定できます。外部ツールのインストールは不要です。
Flow 설계 Best Practices
- 작게 시작: 복잡한 Flow를 한 번에 만들지 말고, 2~3개 컴포넌트로 기본 동작을 확인한 후 점진적으로 확장하세요.
- Playground에서 즉시 테스트: 컴포넌트를 추가할 때마다 Playground에서 동작을 확인하세요.
- 각 컴포넌트 개별 실행: 컴포넌트의 재생(▷) 버튼으로 개별 테스트가 가능합니다. 문제 발생 시 어디서 실패했는지 빠르게 찾을 수 있습니다.
- Freeze 활용: 정상 동작이 확인된 컴포넌트는 Freeze하여 재실행 시 불필요한 API 호출을 줄이세요.
자주 발생하는 문제
10. Pro Tips & Troubleshooting
Flow Design Best Practices
- Start small: Don't build complex Flows at once. Verify basic operation with 2-3 components, then expand.
- Test immediately in Playground: Check behavior after each component addition.
- Run components individually: Use the play (▷) button to test each component. Quickly identify where failures occur.
- Use Freeze: Freeze verified components to avoid unnecessary API calls on re-runs.
Common Issues
10. 实战技巧与故障排除
Flow 设计最佳实践
- 从小开始:不要一次构建复杂 Flow。先用2-3个组件验证基本功能,再逐步扩展。
- 在 Playground 中立即测试:每添加一个组件就检查行为。
- 单独运行组件:使用播放(▷)按钮测试各组件。快速定位故障点。
- 使用 Freeze:冻结已验证的组件,避免重新运行时的不必要 API 调用。
常见问题
10. 実践 Tips & トラブルシューティング
Flow 設計のベストプラクティス
- 小さく始める:複雑な Flow を一度に作らず、2〜3個のコンポーネントで基本動作を確認してから段階的に拡張してください。
- Playground ですぐテスト:コンポーネントを追加するたびに Playground で動作を確認してください。
- 各コンポーネントを個別実行:コンポーネントの再生(▷)ボタンで個別テストが可能です。問題発生時にどこで失敗したか素早く特定できます。
- Freeze を活用:正常動作が確認できたコンポーネントは Freeze して、再実行時の不要な API 呼び出しを削減しましょう。
よくある問題
| 증상 | Symptom | 症状 | 症状 | 원인 | Cause | 原因 | 原因 | 해결 | Solution | 解决 | 解決策 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Playground가 안 보임 | Playground not visible | Playground 不可见 | Playground が表示されない | Chat Output 없음 | No Chat Output | 没有 Chat Output | Chat Output がない | Chat Output 컴포넌트 추가 | Add Chat Output component | 添加 Chat Output 组件 | Chat Output コンポーネントを追加 |
| 채팅 입력이 없고 Run Flow만 보임 | No chat input, only Run Flow | 没有聊天输入,只有 Run Flow | チャット入力がなく Run Flow のみ表示 | Chat Input 없음 | No Chat Input | 没有 Chat Input | Chat Input がない | Chat Input 컴포넌트 추가 | Add Chat Input component | 添加 Chat Input 组件 | Chat Input コンポーネントを追加 |
| 모델 응답 없음 / 타임아웃 | No model response / timeout | 无模型响应 / 超时 | モデルの応答なし / タイムアウト | Base URL 또는 모델명 오류 | Wrong Base URL or model name | Base URL 或模型名称错误 | Base URL またはモデル名のエラー | vLLM 서버 URL과 모델명 재확인 | Verify vLLM server URL and model | 重新确认 vLLM 服务器 URL 和模型 | vLLM サーバーの URL とモデル名を再確認 |
| Agent가 Tool을 호출하지 않음 | Agent doesn't call Tools | Agent 不调用工具 | Agent が Tool を呼び出さない | Tool description 부족 | Poor tool description | 工具描述不足 | Tool の description が不十分 | description을 구체적으로 수정 | Make description more specific | 使描述更具体 | description をより具体的に修正 |
| 포트 연결이 안됨 | Ports won't connect | 端口无法连接 | ポートが接続できない | 타입 불일치 (Message ↔ Data) | Type mismatch (Message ↔ Data) | 类型不匹配(Message ↔ Data) | タイプの不一致(Message ↔ Data) | 출력/입력 타입 확인, 필요시 Parse Data 사용 | Check types, use Parse Data if needed | 检查类型,必要时使用 Parse Data | 出力・入力タイプを確認し、必要に応じて Parse Data を使用 |
| pip install 후 import 에러 | Import error after pip install | pip install 后 import 错误 | pip install 後に import エラー | Langflow 프로세스 재시작 필요 | Langflow process restart needed | 需要重启 Langflow 进程 | Langflow プロセスの再起動が必要 | Langflow 서버 재시작 | Restart Langflow server | 重启 Langflow 服务器 | Langflow サーバーを再起動 |
프롬프트 엔지니어링 팁
- 역할 부여: "당신은 ~한 전문가입니다"로 시작하면 답변 품질이 향상됩니다.
- 출력 형식 지정: "JSON으로 답변하세요", "3가지로 요약하세요" 등 형식을 명시하세요.
- Few-shot 예시: 원하는 입출력 예시를 프롬프트에 포함하면 정확도가 높아집니다.
- 제약 조건: "~하지 마세요", "반드시 ~하세요" 등 경계를 명확히 설정하세요.
- Chain of Thought: "단계별로 생각해주세요"를 추가하면 복잡한 추론에 효과적입니다.
Langflow IDE vs Runtime
Langflow는 개발 환경(IDE)과 운영 환경(Runtime)이 분리되어 있습니다.
- Dev Environment (IDE): 개발자/비즈니스 사용자가 Flow를 설계, 프로토타이핑, 테스트하는 환경
- Production Environment (Runtime): 검증된 Flow가 배포되어 GenAI 애플리케이션이 REST API로 호출하는 환경
Dev에서 충분히 테스트한 Flow를 Production으로 프로모션(승격)하여 운영합니다.
Prompt Engineering Tips
- Assign a role: Start with "You are an expert in ~" to improve answer quality.
- Specify output format: "Reply in JSON", "Summarize in 3 points", etc.
- Few-shot examples: Including input/output examples in prompts improves accuracy.
- Set constraints: "Do not ~", "Always ~" — set clear boundaries.
- Chain of Thought: Adding "Think step by step" helps with complex reasoning.
Langflow IDE vs Runtime
Langflow separates Development (IDE) and Production (Runtime) environments.
- Dev Environment (IDE): Where developers/business users design, prototype, and test Flows
- Production Environment (Runtime): Where validated Flows are deployed; GenAI apps call them via REST API
Flows are promoted from Dev to Production after thorough testing.
提示词工程技巧
- 分配角色:以"你是~领域的专家"开头可提高回答质量。
- 指定输出格式:"用JSON回答"、"总结为3点"等。
- Few-shot 示例:在提示词中包含输入/输出示例可提高准确性。
- 设置约束:"不要~"、"必须~"——设定明确边界。
- 思维链:添加"请逐步思考"有助于复杂推理。
Langflow IDE 与 Runtime
Langflow 将开发环境(IDE)和生产环境(Runtime)分离。
- Dev Environment(IDE):开发者/业务用户设计、原型验证和测试 Flow 的环境
- Production Environment(Runtime):经验证的 Flow 部署后,GenAI 应用通过 REST API 调用
Flow 在 Dev 中充分测试后升级(Promote)到 Production。
プロンプトエンジニアリングのヒント
- 役割の付与:「あなたは〜の専門家です」で始めると回答品質が向上します。
- 出力形式の指定:「JSON で回答してください」「3点に要約してください」など形式を明示します。
- Few-shot 例示:期待する入出力の例をプロンプトに含めると精度が高まります。
- 制約条件:「〜しないでください」「必ず〜してください」など境界を明確に設定します。
- Chain of Thought:「ステップごとに考えてください」を追加すると複雑な推論に効果的です。
Langflow IDE と Runtime
Langflow は開発環境(IDE)と運用環境(Runtime)が分離されています。
- Dev Environment(IDE):開発者・ビジネスユーザーが Flow を設計・プロトタイピング・テストする環境
- Production Environment(Runtime):検証済みの Flow がデプロイされ、GenAI アプリが REST API で呼び出す環境
Dev で十分にテストした Flow を Production へプロモーション(昇格)して運用します。

컨테이너 기반 아키텍처
현재 Langflow는 Kubernetes 클러스터 위에 컨테이너 형태로 배포되어 있습니다. Ingress Controller와 Load Balancer를 통해 여러 Langflow Replica Pod가 요청을 분산 처리하며, Storage Pod에서 Flow 데이터를 관리합니다.
Container-based Architecture
Langflow is deployed as containers on a Kubernetes cluster. An Ingress Controller and Load Balancer distribute requests across multiple Langflow Replica Pods, with a Storage Pod managing Flow data.
基于容器的架构
Langflow 以容器形式部署在 Kubernetes 集群上。通过 Ingress Controller 和 Load Balancer 将请求分配到多个 Langflow Replica Pod,Storage Pod 管理 Flow 数据。
コンテナベースのアーキテクチャ
現在 Langflow は Kubernetes クラスター上にコンテナ形式でデプロイされています。Ingress Controller と Load Balancer を通じて複数の Langflow Replica Pod がリクエストを分散処理し、Storage Pod で Flow データを管理します。

11. Langflow 최신 기능 (1.9 → 1.11)
본 가이드가 처음 작성된 1.9 이후로 두 번의 마이너 릴리스가 있었습니다. 사내 환경의 버전이 제각각일 수 있으므로, 각 기능에 도입 버전을 태그로 표시했습니다. 쓰고 계신 버전보다 높은 태그가 붙은 기능은 아직 없는 기능입니다.
11. What's New in Langflow (1.9 → 1.11)
Two minor releases have landed since this guide was first written against 1.9. Because installations in an organization drift apart, every feature below carries a version tag. If a tag is newer than the version you run, that feature isn't there yet.
11. Langflow 最新功能 (1.9 → 1.11)
自本指南基于 1.9 编写以来,已发布两个次要版本。由于各处环境的版本可能不一致,下列每项功能均标注了引入版本标签。标签高于您所用版本的功能,即尚未提供的功能。
11. Langflow 最新機能 (1.9 → 1.11)
本ガイドが 1.9 を基準に書かれて以降、2回のマイナーリリースがありました。社内環境のバージョンはまちまちになりがちなため、各機能に導入バージョンのタグを付けています。お使いのバージョンより新しいタグの機能は、まだ存在しない機能です。
| 버전Version版本バージョン | 출시Released发布リリース | 대표 기능Headline features代表功能代表的な機能 |
|---|---|---|
| 1.9 | 2026.04 | Langflow Assistant, Flow DevOps 툴킷, IDE/코딩 에이전트용 MCPLangflow Assistant, Flow DevOps toolkit, MCP for IDEs and coding agentsLangflow Assistant、Flow DevOps 工具包、面向 IDE/编码代理的 MCPLangflow Assistant、Flow DevOps ツールキット、IDE/コーディングエージェント向け MCP |
| 1.10 | 2026.06 | Assistant의 Flow 전체 생성, Memory Bases, DB Providers, UI 다국어Assistant builds whole flows, Memory Bases, DB Providers, UI internationalizationAssistant 生成完整 Flow、Memory Bases、DB Providers、UI 多语言Assistant による Flow 全体生成、Memory Bases、DB Providers、UI 多言語化 |
| 1.11 | 2026.07 | Human-in-the-Loop, A2A 프로토콜, Workflow API v2, Data Operations 통합Human-in-the-Loop, A2A protocol, Workflow API v2, unified Data OperationsHuman-in-the-Loop、A2A 协议、Workflow API v2、Data Operations 整合Human-in-the-Loop、A2A プロトコル、Workflow API v2、Data Operations 統合 |
업그레이드를 계획 중이라면
1.11은 신기능뿐 아니라 설치 방식과 인증 기본값도 바꿨습니다. 실제로 올리기 전에 12장 업그레이드 & 폐쇄망 체크리스트를 먼저 확인하세요.
Langflow Assistant — 이제 Flow 전체를 만듭니다1.9 → 1.10
Langflow UI 안에 내장된 AI 어시스턴트입니다. 1.9에서는 자연어로 설명하면 Custom Component 코드를 생성해 주는 수준이었지만, 1.10부터는 컴포넌트가 서로 연결된 Flow 전체를 만들어냅니다. "URL에서 제목을 뽑아 채팅으로 답하는 Flow를 만들어줘"라고 하면 Chat Input → 커스텀 컴포넌트 → Chat Output까지 배선된 상태로 완성됩니다.
사용 방법
- LLM Provider 설정: Settings에서 Assistant가 사용할 LLM Provider를 먼저 구성합니다.
- Assistant 열기: Langflow UI에서 Assistant를 실행합니다.
- 자연어로 설명: 원하는 기능을 자연어로 입력합니다 (프롬프트 최대 500자).
- 생성 및 검증: Assistant가 Flow를 생성하고, 직접 실행해 결과까지 확인합니다.
폐쇄망에서 Assistant 쓰기
Assistant는 동작할 LLM이 있어야 쓸 수 있습니다. 외부 Provider를 쓸 수 없으므로, Settings의 Global Model Provider에서 사내 vLLM을 OpenAI Compatible Provider로 등록해 두어야 합니다. 이 설정이 없으면 Assistant는 열려도 아무 것도 생성하지 못합니다.
Planning an upgrade?
1.11 changed more than features — installation layout and authentication defaults moved too. Read Chapter 12, Upgrading & Air-gapped Checklist before you roll it out.
Langflow Assistant — Now It Builds Entire Flows1.9 → 1.10
An AI assistant built into the Langflow UI. On 1.9 it generated Custom Component code from a natural-language description; since 1.10 it produces a complete, wired-up flow. Ask for "a flow that extracts titles from URLs and answers in chat" and you get Chat Input → custom component → Chat Output already connected.
How to use it
- Configure an LLM provider: set up the provider the Assistant will use in Settings.
- Open the Assistant: launch it from the Langflow UI.
- Describe it in natural language: type what you want (prompt limit 500 characters).
- Generate and validate: the Assistant builds the flow, runs it, and checks the result.
Using the Assistant air-gapped
The Assistant needs a working LLM behind it. Since external providers are off the table, register your internal vLLM as an OpenAI Compatible provider under Global Model Provider in Settings. Without that, the Assistant opens but can't generate anything.
正在计划升级?
1.11 改变的不只是功能,安装方式与认证默认值也已变更。实际部署前请先阅读第 12 章 升级 & 封闭网络检查清单。
Langflow Assistant — 现在可生成完整 Flow1.9 → 1.10
内置于 Langflow UI 中的 AI 助手。在 1.9 中,它根据自然语言描述生成自定义组件代码;自 1.10 起可生成组件间已连线的完整 Flow。只需说"做一个从 URL 提取标题并在聊天中回复的 Flow",即可得到 Chat Input → 自定义组件 → Chat Output 已连接的成品。
使用方法
- 配置 LLM Provider:先在 Settings 中配置 Assistant 使用的 LLM Provider。
- 打开 Assistant:在 Langflow UI 中启动。
- 用自然语言描述:输入所需功能(提示词上限 500 字符)。
- 生成与验证:Assistant 生成 Flow 并直接运行确认结果。
在封闭网络中使用 Assistant
Assistant 需要有可用的 LLM 支撑。由于无法使用外部 Provider,须在 Settings 的 Global Model Provider 中将内部 vLLM 注册为 OpenAI Compatible Provider。缺少该设置时,Assistant 虽能打开却无法生成任何内容。
アップグレードを計画中なら
1.11 は機能だけでなくインストール方式と認証の既定値も変更しています。実際に上げる前に12章 アップグレード & 閉域網チェックリストをご確認ください。
Langflow Assistant — Flow 全体を作れるように1.9 → 1.10
Langflow UI に内蔵された AI アシスタントです。1.9 では自然言語の説明からカスタムコンポーネントのコードを生成する程度でしたが、1.10 からはコンポーネントが繋がった Flow 全体を作り上げます。「URL からタイトルを抽出してチャットで答える Flow を作って」と頼めば、Chat Input → カスタムコンポーネント → Chat Output まで配線された状態で完成します。
使い方
- LLM Provider の設定:Assistant が使う LLM Provider を Settings で先に構成します。
- Assistant を開く:Langflow UI から起動します。
- 自然言語で説明:欲しい機能を入力します(プロンプト最大500文字)。
- 生成と検証:Assistant が Flow を生成し、実行して結果まで確認します。
閉域網で Assistant を使う
Assistant は動作する LLM が背後に必要です。外部 Provider は使えないため、Settings の Global Model Provider で社内 vLLM を OpenAI Compatible Provider として登録しておく必要があります。この設定がないと、Assistant は開いても何も生成できません。
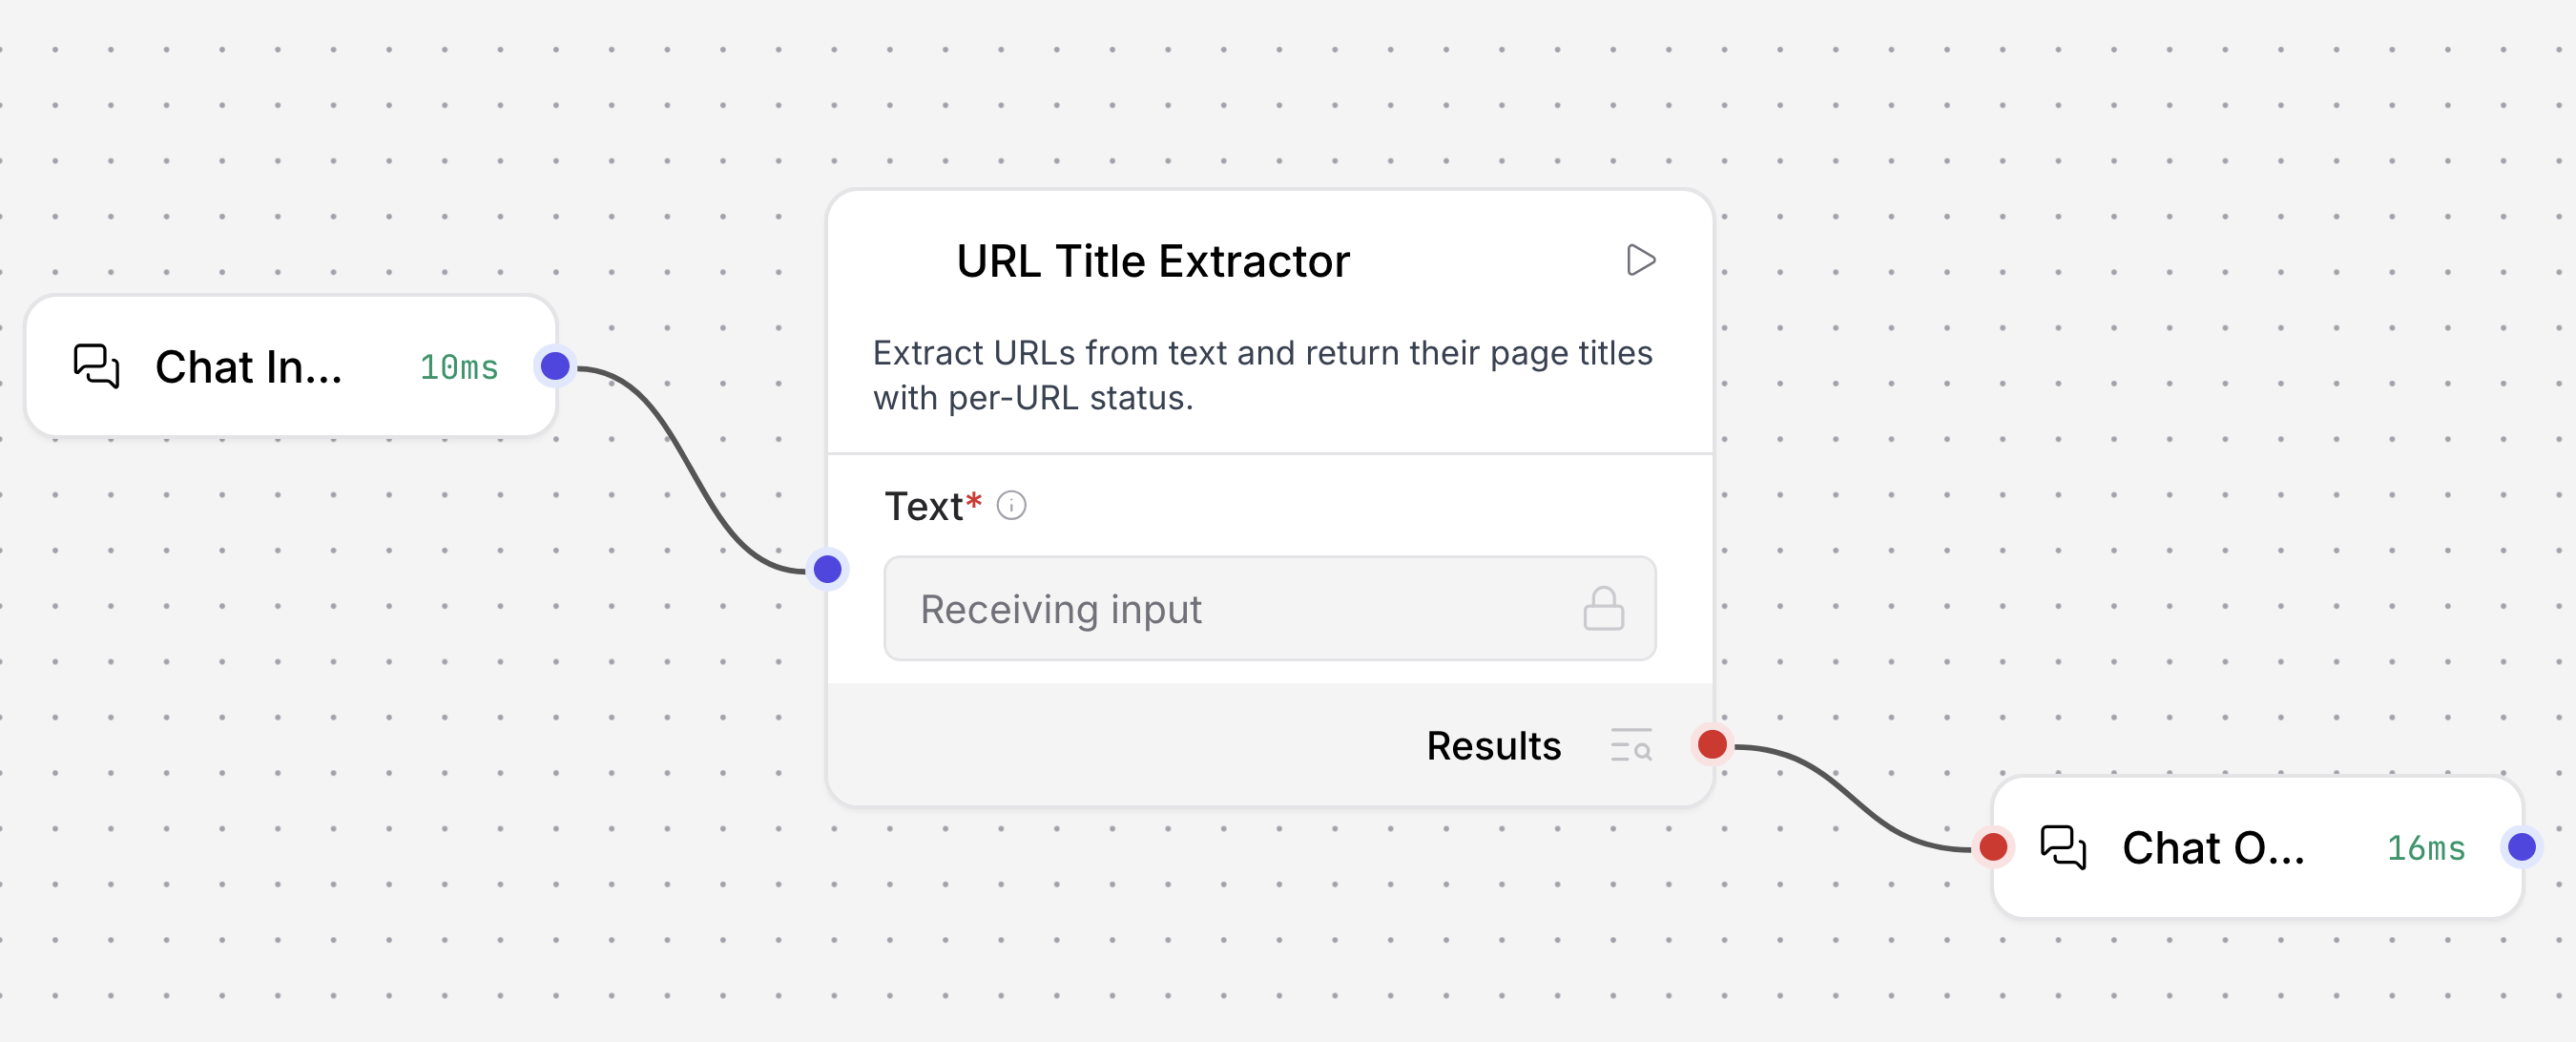
Assistant가 생성한 Flow — 컴포넌트가 연결된 상태로 완성됩니다. 출처: A flow generated by the Assistant — delivered fully connected. Source: Assistant 生成的 Flow — 组件已连线完成。来源:Assistant が生成した Flow — 接続済みの状態で完成します。出典:Langflow Docs


Memory Bases — 세션을 넘어서는 대화 기억1.10
기존 Chat Memory는 같은 세션 안에서 최근 메시지를 시간순으로 불러오는 방식이었습니다. Memory Base는 대화 메시지를 자동으로 임베딩해 벡터로 저장하고, 질문과 의미가 가까운 과거 대화를 세션 경계를 넘어 찾아옵니다. "지난주에 얘기했던 그 설비 이슈"를 Agent가 기억하게 만드는 기능입니다.
비슷해 보이는 세 가지 개념을 구분하는 것이 핵심입니다.
Memory Bases — Conversation Memory Across Sessions1.10
Classic chat memory pulls recent messages in chronological order within one session. A Memory Base instead embeds conversation messages into a vector store automatically and retrieves past exchanges that are semantically close to the current question — across session boundaries. This is what lets an agent remember "that equipment issue we discussed last week."
The key is telling three similar-looking concepts apart.
Memory Bases — 跨会话的对话记忆1.10
传统 Chat Memory 是在同一会话内按时间顺序调取最近消息。而 Memory Base 会自动将对话消息嵌入并存为向量,跨越会话边界检索与当前问题语义相近的历史对话。这正是让 Agent 记住"上周聊过的那个设备问题"的功能。
关键在于区分三个看似相似的概念。
Memory Bases — セッションを越える会話の記憶1.10
従来の Chat Memory は同一セッション内の直近メッセージを時系列で取得する方式でした。Memory Base は会話メッセージを自動的に埋め込みベクトルとして保存し、質問と意味的に近い過去の会話をセッションの境界を越えて探し出します。「先週話したあの設備の問題」を Agent に覚えさせる機能です。
似て見える3つの概念を区別することが重要です。
| 구분 区分区分 | 데이터 출처Where data comes from数据来源データの出所 | 검색 방식Retrieval检索方式検索方式 | 범위Scope范围範囲 |
|---|---|---|---|
| Message History | messages 테이블 (자동)messages table (automatic)messages 表(自动)messages テーブル(自動) | 시간순Chronological按时间顺序時系列 | 단일 세션Single session单一会话単一セッション |
| Memory Base1.10 | 대화 메시지 (자동 임베딩)Chat messages (auto-embedded)对话消息(自动嵌入)会話メッセージ(自動埋め込み) | 의미 유사도Semantic similarity语义相似度意味的類似度 | 세션 간 (Flow 단위)Across sessions (per flow)跨会话(按 Flow)セッション横断(Flow 単位) |
| Knowledge Base | 업로드한 문서 (수동)Uploaded documents (manual)上传的文档(手动)アップロードした文書(手動) | 의미 유사도Semantic similarity语义相似度意味的類似度 | Flow 무관 (공용)Flow-independent (shared)与 Flow 无关(共用)Flow 非依存(共用) |
만들고 연결하기
- 좌측 사이드바에서 Memories → Create를 누르고, 이름과 Embedding Model을 지정합니다.
- Flow에 Memory Base 컴포넌트를 놓고 방금 만든 메모리를 드롭다운에서 선택합니다.
- 컴포넌트의 Tool Mode를 켠 뒤, 출력을 Agent의 Tools 입력에 연결합니다 (7장 Tool Mode 참조).
주요 옵션
- Auto-capture — 기본 활성. 메시지가 일정량 쌓이면 자동으로 적재됩니다.
- LLM Preprocessing — 임베딩 전에 LLM으로 대화를 요약(distill)합니다. 잡담이 많은 대화에서 검색 품질이 올라갑니다.
- Kill phrases — 응답에 특정 문구가 있으면 적재를 건너뜁니다. 기본값은
NO_INGEST입니다. - 세션 필터링 — 기본값은 현재 세션의 청크만 조회합니다. 세션을 넘어 검색하려면 이 설정을 조정해야 합니다.
민감정보 주의
Auto-capture가 켜져 있으면 대화 내용이 자동으로 벡터 저장소에 남습니다. 사내 기밀이나 개인정보가 오가는 Flow라면 Kill phrases를 설정하거나 Auto-capture를 꺼 두는 편이 안전합니다.
Creating and connecting one
- Click Memories in the left sidebar → Create, then give it a name and an embedding model.
- Drop a Memory Base component into your flow and pick the memory you just created from the dropdown.
- Turn on Tool Mode and wire its output to the Agent's Tools input (see Chapter 7, Tool Mode).
Key options
- Auto-capture — on by default; ingestion triggers once messages reach a batch threshold.
- LLM Preprocessing — distills conversations with an LLM before embedding. Improves retrieval quality on chatty conversations.
- Kill phrases — skip ingestion when a response contains a given term. Default is
NO_INGEST. - Session filtering — by default only chunks from the current session are retrieved. Adjust this to search across sessions.
Careful with sensitive data
With Auto-capture on, conversation content persists into a vector store automatically. If a flow handles confidential or personal information, set Kill phrases or turn Auto-capture off.
创建与连接
- 在左侧边栏点击 Memories → Create,指定名称和 Embedding Model。
- 在 Flow 中放置 Memory Base 组件,并从下拉菜单选择刚创建的记忆库。
- 开启组件的 Tool Mode,将其输出连接到 Agent 的 Tools 输入(参见第 7 章 Tool Mode)。
主要选项
- Auto-capture — 默认开启。消息累积到阈值时自动写入。
- LLM Preprocessing — 嵌入前用 LLM 对对话进行提炼。在闲聊较多的对话中可提升检索质量。
- Kill phrases — 响应中包含特定短语时跳过写入。默认值为
NO_INGEST。 - 会话过滤 — 默认仅检索当前会话的分块。如需跨会话检索,须调整此设置。
注意敏感信息
开启 Auto-capture 时,对话内容会自动留存于向量存储中。若 Flow 涉及公司机密或个人信息,建议设置 Kill phrases 或关闭 Auto-capture。
作成と接続
- 左サイドバーの Memories → Create を押し、名前と Embedding Model を指定します。
- Flow に Memory Base コンポーネントを置き、作成したメモリをドロップダウンで選択します。
- コンポーネントの Tool Mode を有効にし、出力を Agent の Tools 入力に接続します(7章 Tool Mode 参照)。
主なオプション
- Auto-capture — 既定で有効。メッセージが一定量たまると自動的に取り込まれます。
- LLM Preprocessing — 埋め込み前に LLM で会話を要約(distill)します。雑談の多い会話で検索品質が向上します。
- Kill phrases — 応答に特定の文言が含まれる場合、取り込みをスキップします。既定値は
NO_INGESTです。 - セッションフィルタ — 既定では現在のセッションのチャンクのみ取得します。セッションを越えて検索するには調整が必要です。
機密情報に注意
Auto-capture が有効だと会話内容が自動的にベクトルストアに残ります。社外秘や個人情報を扱う Flow では、Kill phrases を設定するか Auto-capture を無効にする方が安全です。
Human-in-the-Loop (HITL) — 사람의 승인을 기다리는 Flow1.11
Agent에게 실제 권한을 주려면 "이 작업은 사람이 한 번 봐야 한다"는 지점이 반드시 생깁니다. HITL은 Flow를 그 지점에서 일시정지하고 checkpoint를 만든 뒤, 사람의 판단을 기다립니다. 승인/거부를 선택하면 checkpoint에서 재개되며, 이미 끝난 단계는 다시 실행되지 않습니다.
두 가지 방식
- Human Input 컴포넌트 — 설정한 액션(예: Approve / Reject)마다 출력 분기가 생깁니다. 승인과 거부에서 서로 다른 경로를 태우고 싶을 때 씁니다.
- Agent Tool의 "Requires approval" — 특정 Tool에만 승인 게이트를 겁니다. 분기를 만들지 않고 해당 Tool 실행 직전에만 멈춥니다. 위험한 도구 하나만 막고 싶을 때 간단합니다.
Human-in-the-Loop (HITL) — Flows That Wait for Approval1.11
The moment you give an agent real authority, some step inevitably needs a human to look at it. HITL pauses the flow there and creates a checkpoint while it waits for a decision. Once approved or rejected, the run resumes from the checkpoint — and steps that already finished are not re-executed.
Two ways to do it
- Human Input component — creates an output branch per configured action (e.g. Approve / Reject). Use it when approval and rejection should follow different paths.
- "Requires approval" on an agent tool — gates one specific tool. It adds no branches and simply pauses right before that tool runs. Simplest when you only need to gate one risky tool.
Human-in-the-Loop (HITL) — 等待人工审批的 Flow1.11
一旦赋予 Agent 实际权限,必然出现"这一步需要人来看一眼"的节点。HITL 会在该节点暂停 Flow 并创建 checkpoint,等待人工判断。选择批准/拒绝后,运行将从 checkpoint 恢复,且已完成的步骤不会重新执行。
两种方式
- Human Input 组件 — 为每个配置的动作(如 Approve / Reject)生成输出分支。适用于批准与拒绝需走不同路径的场景。
- Agent Tool 的 "Requires approval" — 仅对特定 Tool 设置审批门。不生成分支,只在该 Tool 执行前暂停。仅需拦截某个高风险工具时更为简便。
Human-in-the-Loop (HITL) — 人の承認を待つ Flow1.11
Agent に実際の権限を与えると、「この作業は人が一度確認すべき」という地点が必ず生じます。HITL はその地点で Flow を一時停止して checkpoint を作り、人の判断を待ちます。承認/却下を選ぶと checkpoint から再開され、すでに完了した工程は再実行されません。
2つの方式
- Human Input コンポーネント — 設定したアクション(例:Approve / Reject)ごとに出力の分岐ができます。承認と却下で別の経路を通したい場合に使います。
- Agent Tool の「Requires approval」 — 特定の Tool にのみ承認ゲートをかけます。分岐を作らず、その Tool の実行直前だけ停止します。危険な道具を1つだけ止めたい場合に簡単です。
⏸ checkpoint
폐쇄망 실무에서의 가치
사내 자동화는 대부분 결재/승인 절차를 통과해야 합니다. HITL은 "Agent가 초안을 만들고 담당자가 승인하면 실제 반영"이라는 패턴을 Flow 안에서 그대로 구현할 수 있게 해 줍니다. 승인 대기 중에도 앞 단계의 계산 결과가 보존되므로, 승인이 늦어져도 처음부터 다시 돌릴 필요가 없습니다.
Why this matters in practice
Most internal automation has to pass through an approval process. HITL lets you express "the agent drafts it, a reviewer approves, then it takes effect" directly inside the flow. Because results from earlier steps are preserved while it waits, a slow approval doesn't mean re-running everything.
在实务中的价值
企业内部自动化大多必须经过审批流程。HITL 让"Agent 生成草案、负责人批准后才实际生效"这一模式直接在 Flow 中实现。等待审批期间前序步骤的计算结果会被保留,因此审批延迟也无需从头重跑。
実務における価値
社内自動化の多くは決裁・承認プロセスを通す必要があります。HITL は「Agent が草案を作り、担当者が承認したら実際に反映」というパターンを Flow の中でそのまま実装できます。承認待ちの間も前工程の計算結果が保持されるため、承認が遅れても最初からやり直す必要はありません。
A2A (Agent2Agent) 프로토콜1.11
Flow를 A2A 에이전트로 게시하면 외부 에이전트가 이를 발견하고 호출할 수 있고, 반대로 원격 A2A 에이전트를 내 Flow 안에서 호출할 수도 있습니다. 게시하면 /api/v1/a2a/<flow-id> 주소가 생기고, 다른 에이전트가 읽을 수 있는 Agent Card(이름, 설명, 입력 계약, 태그, 예시)가 함께 노출됩니다.
기본 비활성
A2A는 기본적으로 꺼져 있습니다. LANGFLOW_A2A_ENABLED=true 환경변수를 설정해야 활성화됩니다.
MCP와 무엇이 다른가
- MCP — Flow를 도구(Tool)로 노출합니다. 호출하는 쪽이 주도권을 갖고, Flow는 함수처럼 불려갑니다.
- A2A — Flow를 에이전트로 노출합니다. 상대도 자율적으로 판단하는 주체이며, 에이전트 간 작업 위임에 가깝습니다.
A2A (Agent2Agent) Protocol1.11
Publish a flow as an A2A agent and other agents can discover and invoke it; conversely, you can call remote A2A agents from inside your own flow. Publishing exposes an address at /api/v1/a2a/<flow-id> along with an Agent Card — name, description, input contract, tags, and examples — that other agents can read.
Off by default
A2A is disabled unless you set the environment variable LANGFLOW_A2A_ENABLED=true.
How is this different from MCP?
- MCP — exposes a flow as a tool. The caller holds the initiative and the flow gets invoked like a function.
- A2A — exposes a flow as an agent. The other side reasons for itself too; this is closer to delegating work between agents.
A2A (Agent2Agent) 协议1.11
将 Flow 发布为 A2A 代理后,外部代理即可发现并调用它;反之也可在自己的 Flow 中调用远程 A2A 代理。发布后会生成 /api/v1/a2a/<flow-id> 地址,并同时公开可供其他代理读取的 Agent Card(名称、描述、输入契约、标签、示例)。
默认关闭
A2A 默认处于关闭状态,需设置环境变量 LANGFLOW_A2A_ENABLED=true 才会启用。
与 MCP 有何不同
- MCP — 将 Flow 暴露为工具(Tool)。主动权在调用方,Flow 像函数一样被调用。
- A2A — 将 Flow 暴露为代理(Agent)。对方同样是自主判断的主体,更接近代理间的任务委派。
A2A (Agent2Agent) プロトコル1.11
Flow を A2A エージェントとして公開すると、外部エージェントがそれを発見し呼び出せるようになり、逆にリモートの A2A エージェントを自分の Flow 内から呼ぶこともできます。公開すると /api/v1/a2a/<flow-id> のアドレスが生成され、他のエージェントが読み取れる Agent Card(名前、説明、入力契約、タグ、例)も併せて公開されます。
既定では無効
A2A は既定で無効です。環境変数 LANGFLOW_A2A_ENABLED=true を設定して有効化する必要があります。
MCP と何が違うのか
- MCP — Flow をツール(Tool)として公開します。主導権は呼び出す側にあり、Flow は関数のように呼ばれます。
- A2A — Flow をエージェントとして公開します。相手も自律的に判断する主体であり、エージェント間のタスク委譲に近い関係です。
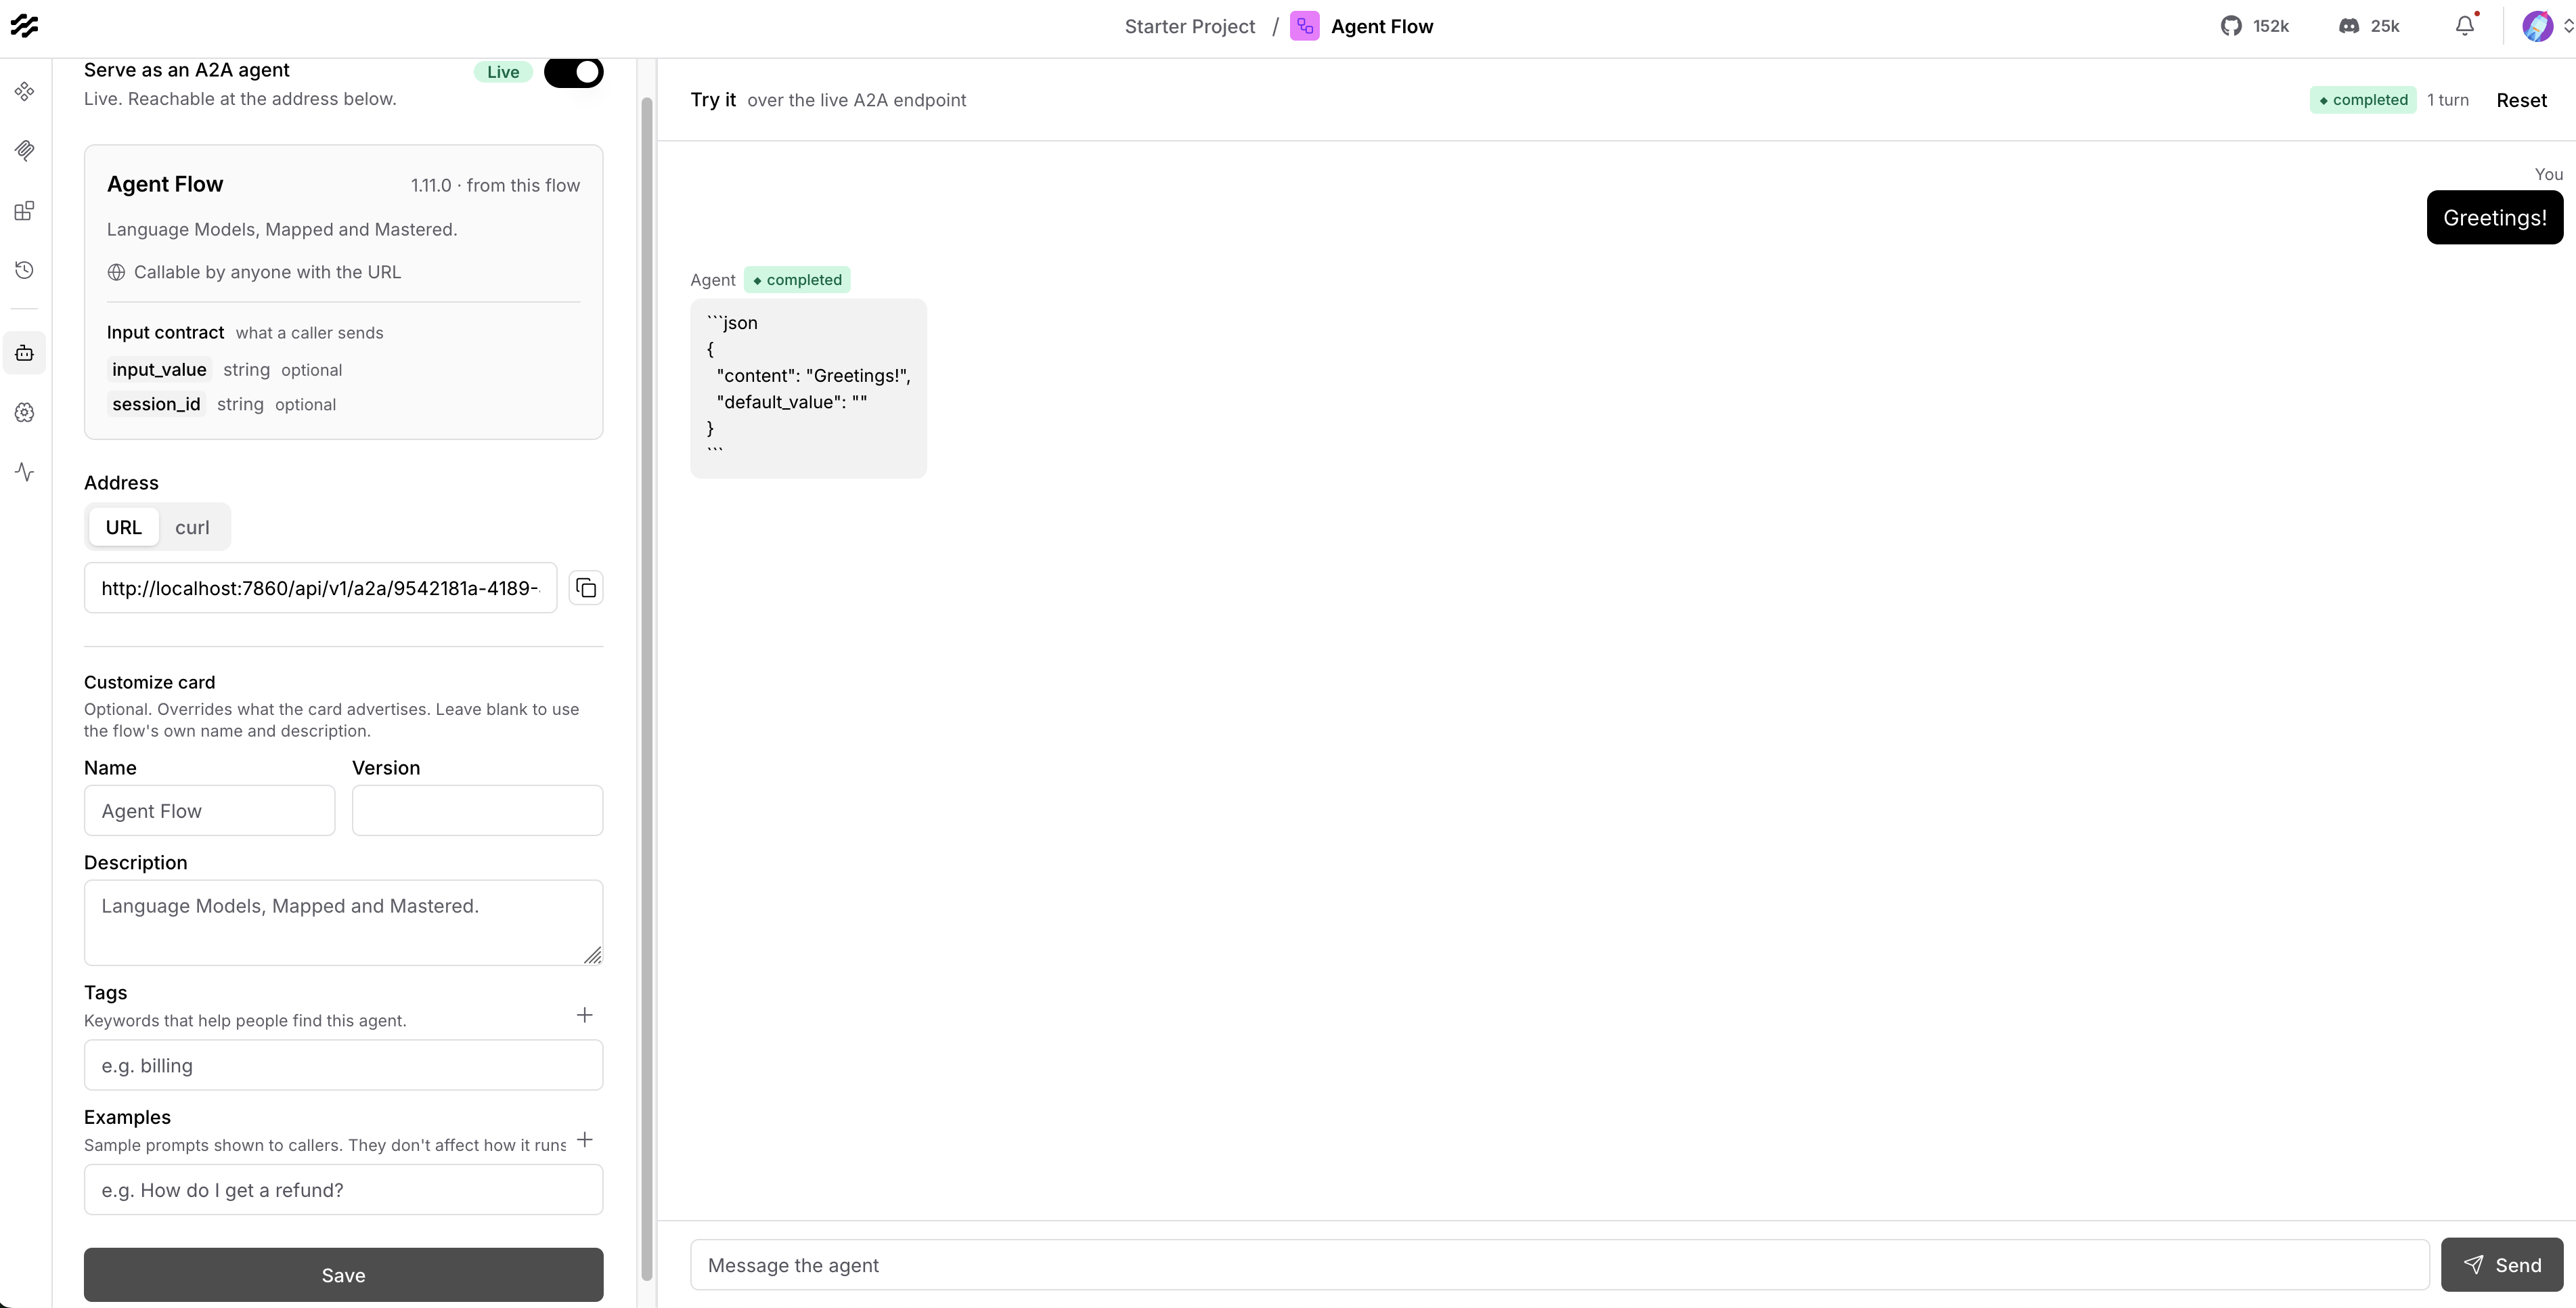
Flow를 A2A 에이전트로 게시하는 화면 — Agent Card와 엔드포인트 주소가 함께 표시됩니다. 출처: Publishing a flow as an A2A agent — the Agent Card and endpoint address appear together. Source: 将 Flow 发布为 A2A 代理的界面 — 同时显示 Agent Card 与端点地址。来源:Flow を A2A エージェントとして公開する画面 — Agent Card とエンドポイントが併せて表示されます。出典:Langflow Docs
Workflow API v2 & AG-UI 스트리밍1.11
Flow를 외부에서 호출하는 새로운 API가 추가되었습니다. sync / stream / background 세 가지 실행 모드와 AG-UI 프로토콜 스트리밍을 지원합니다. 기존 /api/v1/responses도 그대로 쓸 수 있으며, 두 API의 선택 기준과 예제 코드는 8장 API Access에서 자세히 다룹니다.
UI 다국어 지원1.10
Langflow UI 자체가 7개 언어를 지원합니다 — 영어, 프랑스어, 스페인어, 독일어, 포르투갈어, 일본어, 중국어. 프로필 설정에서 변경합니다.
한국어는 아직 미지원
현재 목록에 한국어는 포함되어 있지 않습니다. 국내 팀에 배포할 때는 UI가 영어로 표시된다는 점을 감안해 교육 자료를 준비하세요.
기타 주요 개선
- Redis 기반 Job Queue 1.10 — 멀티워커 배포에서 작업을 안정적으로 분배합니다.
- Python 3.10–3.14 지원 1.10 — 공식 Docker 이미지는 3.14 기준입니다.
- File System 컴포넌트 1.10 — 샌드박스가 적용된 파일 read/write. read-only 모드로 제한할 수 있습니다.
- IBM Db2 컴포넌트 1.10 — 엔터프라이즈 DB 연동.
- MCP 기반 상호운용성 1.9 — 모든 Flow가 자동으로 MCP Tool로 노출되어, 외부 에이전트나 IDE가 Visual Builder 없이 Flow를 실행할 수 있습니다.
- 배포 스테퍼 UI 1.9 — Flow 배포를 단계별로 안내하는 배포 페이지.
- 글로벌 모델 설정 1.8 — API 키를 한 번만 설정하면 모든 Flow에서 공유됩니다.
- Traces 1.8 — Flow 실행 과정을 단계별로 추적·디버깅 (10장 참조).
Workflow API v2 & AG-UI Streaming1.11
A new API for calling flows from outside, with three execution modes — sync / stream / background — and AG-UI protocol streaming. The existing /api/v1/responses still works; see Chapter 8, API Access for how to choose between them, with example code.
UI Internationalization1.10
The Langflow UI itself speaks seven languages — English, French, Spanish, German, Portuguese, Japanese, and Chinese. Switch in your profile settings.
Korean is not supported yet
Korean is not on that list. When rolling out to Korean-speaking teams, plan training material around a UI that will display in English.
Other Notable Improvements
- Redis-backed job queue 1.10 — reliable work distribution across multi-worker deployments.
- Python 3.10–3.14 support 1.10 — official Docker images are built on 3.14.
- File System component 1.10 — sandboxed file read/write, restrictable to read-only.
- IBM Db2 component 1.10 — enterprise database integration.
- MCP interoperability 1.9 — every flow is exposed as an MCP tool automatically, so external agents and IDEs can run flows without the Visual Builder.
- Deployment stepper UI 1.9 — a guided, step-by-step deployment page.
- Global model settings 1.8 — configure API keys once and share them across all flows.
- Traces 1.8 — step-by-step execution tracing and debugging (see Chapter 10).
Workflow API v2 & AG-UI 流式传输1.11
新增了从外部调用 Flow 的 API,支持 sync / stream / background 三种执行模式以及 AG-UI 协议流式传输。原有的 /api/v1/responses 仍可继续使用;两者的选择标准与示例代码详见第 8 章 API Access。
UI 多语言支持1.10
Langflow UI 本身支持 7 种语言 — 英语、法语、西班牙语、德语、葡萄牙语、日语、中文。在个人资料设置中切换。
尚不支持韩语
当前列表中不包含韩语。向韩语团队推广时,请按 UI 显示为英语的前提准备培训材料。
其他主要改进
- 基于 Redis 的 Job Queue 1.10 — 在多 worker 部署中稳定分配任务。
- 支持 Python 3.10–3.14 1.10 — 官方 Docker 镜像基于 3.14。
- File System 组件 1.10 — 带沙箱的文件读写,可限制为只读模式。
- IBM Db2 组件 1.10 — 企业级数据库集成。
- 基于 MCP 的互操作性 1.9 — 所有 Flow 自动暴露为 MCP 工具,外部代理与 IDE 无需 Visual Builder 即可执行 Flow。
- 部署引导 UI 1.9 — 分步引导的部署页面。
- 全局模型设置 1.8 — API 密钥一次配置,所有 Flow 共享。
- Traces 1.8 — 逐步追踪与调试 Flow 执行过程(参见第 10 章)。
Workflow API v2 & AG-UI ストリーミング1.11
Flow を外部から呼び出す新しい API が追加されました。sync / stream / background の3つの実行モードと AG-UI プロトコルのストリーミングに対応します。既存の /api/v1/responses もそのまま利用可能で、両者の選択基準とサンプルコードは8章 API Access で詳しく扱います。
UI の多言語対応1.10
Langflow UI 自体が7言語に対応します — 英語、フランス語、スペイン語、ドイツ語、ポルトガル語、日本語、中国語。プロフィール設定で変更します。
韓国語は未対応
現在のリストに韓国語は含まれていません。韓国語チームへ展開する際は、UI が英語表示になる前提で教育資料を準備してください。
その他の主要な改善
- Redis ベースの Job Queue 1.10 — マルチワーカー配備でタスクを安定して分配します。
- Python 3.10–3.14 対応 1.10 — 公式 Docker イメージは 3.14 ベースです。
- File System コンポーネント 1.10 — サンドボックス付きのファイル読み書き。read-only モードに制限可能です。
- IBM Db2 コンポーネント 1.10 — エンタープライズ DB 連携。
- MCP ベースの相互運用性 1.9 — すべての Flow が自動的に MCP ツールとして公開され、外部エージェントや IDE が Visual Builder なしで Flow を実行できます。
- デプロイステッパー UI 1.9 — 段階的に案内するデプロイページ。
- グローバルモデル設定 1.8 — API キーを一度設定すれば全 Flow で共有されます。
- Traces 1.8 — Flow 実行のステップごとの追跡・デバッグ(10章参照)。
12. 1.11 업그레이드 & 폐쇄망 체크리스트
1.11은 편리한 신기능만 들어온 릴리스가 아닙니다. 설치 방식과 기본 인증 동작이 바뀌어, 기존 방식 그대로 올리면 컨테이너가 아예 뜨지 않거나 쓰던 컴포넌트가 사라질 수 있습니다. 폐쇄망 운영자가 반드시 먼저 읽어야 할 내용입니다.
12. Upgrading to 1.11 & Air-gapped Checklist
1.11 isn't just a bag of new features. Installation layout and default authentication behavior both changed, so lifting your existing setup as-is can leave the container refusing to start, or components you relied on missing. Read this first if you operate an air-gapped instance.
12. 1.11 升级 & 封闭网络检查清单
1.11 并非只带来便利的新功能。安装方式与默认认证行为均已改变,若按原样部署,容器可能根本无法启动,或原本使用的组件消失。封闭网络运维人员务必优先阅读。
12. 1.11 アップグレード & 閉域網チェックリスト
1.11 は便利な新機能だけのリリースではありません。インストール方式と既定の認証動作が変更されており、従来のまま起動するとコンテナが立ち上がらない、使っていたコンポーネントが消えるといった事態が起こり得ます。閉域網の運用担当者は必ず先に目を通してください。
12-1. lfx-bundles 분리 — 폐쇄망 최대 이슈1.11
1.11부터 상당수의 서드파티 통합이 core langflow 패키지에서 빠져나와 lfx-bundles 패키지의 long-tail 번들로 이동했습니다. 인터넷이 되는 환경에서는 pip install이 알아서 끌어오므로 티가 나지 않지만, 폐쇄망에서는 "있던 컴포넌트가 사라졌다"로 나타납니다.
12-1. The lfx-bundles Split — The Big One for Air-gapped Sites1.11
As of 1.11, many third-party integrations moved out of the core langflow package into long-tail bundles inside the lfx-bundles package. With internet access pip install pulls them in and you never notice. Air-gapped, it shows up as "components that used to be there are gone."
12-1. lfx-bundles 拆分 — 封闭网络的最大问题1.11
从 1.11 起,大量第三方集成已从核心 langflow 包移出,转入 lfx-bundles 包中的 long-tail 捆绑包。在联网环境中 pip install 会自动拉取,毫无察觉;但在封闭网络中,表现为"原有组件消失了"。
12-1. lfx-bundles の分離 — 閉域網における最大の課題1.11
1.11 から多くのサードパーティ統合が core langflow パッケージを離れ、lfx-bundles パッケージの long-tail バンドルへ移動しました。インターネットがあれば pip install が自動取得するため気づきませんが、閉域網では「あったはずのコンポーネントが消えた」という形で表面化します。
| 설치 명령Install command安装命令インストールコマンド | 포함되는 것What you get包含内容含まれるもの |
|---|---|
uv pip install langflow | 주요 provider 번들 포함 (일반적인 선택)Core plus the main provider bundles (the usual choice)核心加主要 provider 捆绑包(常规选择)主要 provider バンドルを含む(通常の選択) |
uv pip install lfx | 실행 엔진만. 컴포넌트 없음 — 1.10 이하와 동작이 다름Executor engine only, no components — differs from 1.10 and earlier仅执行引擎,不含组件 — 与 1.10 及以前不同実行エンジンのみ、コンポーネントなし — 1.10 以前と挙動が異なる |
uv pip install "lfx-bundles[all]" | PyTorch 의존 컴포넌트까지 전부 (CUGA, Code Agents, Docling 로컬 파서)Everything including PyTorch-dependent components (CUGA, Code Agents, Docling local parser)包含 PyTorch 依赖组件在内的全部(CUGA、Code Agents、Docling 本地解析器)PyTorch 依存コンポーネントまで全部(CUGA、Code Agents、Docling ローカルパーサー) |
PyTorch 의존 컴포넌트는 이제 opt-in
기본 설치에서 제외됩니다. 1.11.x 기준 해당 대상은 CUGA, Code Agents, Docling 로컬 파서입니다. 문서 파싱에 Docling을 쓰고 계셨다면 업그레이드 후 동작하지 않으므로, lfx-bundles[all]을 별도로 반입해야 합니다. PyTorch는 wheel 용량이 크므로 반입 계획에 미리 반영하세요.
폐쇄망 반입 절차
인터넷 구간에서 wheel을 먼저 수집한 뒤, 사내로 옮겨 오프라인 설치합니다. 운영 환경과 동일한 Python 버전 / OS / CPU 아키텍처에서 수집해야 합니다 — 그렇지 않으면 플랫폼이 맞지 않는 wheel을 받게 됩니다.
PyTorch-dependent components are now opt-in
They are excluded from a default install. On 1.11.x that means CUGA, Code Agents, and the Docling local parser. If you relied on Docling for document parsing it will stop working after the upgrade, so bring lfx-bundles[all] across separately. PyTorch wheels are large — budget for that in your transfer plan.
Bringing packages into an air-gapped network
Collect wheels on an internet-connected machine, move them inside, and install offline. Collect on the same Python version, OS, and CPU architecture as production — otherwise you'll end up with wheels for the wrong platform.
PyTorch 依赖组件现为 opt-in
默认安装中不再包含。1.11.x 中对应 CUGA、Code Agents 和 Docling 本地解析器。若此前依赖 Docling 进行文档解析,升级后将无法运行,需另行导入 lfx-bundles[all]。PyTorch 的 wheel 体积较大,请提前纳入导入计划。
封闭网络导入流程
先在联网环境收集 wheel,再转入内网离线安装。必须在与生产环境相同的 Python 版本 / 操作系统 / CPU 架构上收集,否则会得到平台不匹配的 wheel。
PyTorch 依存コンポーネントは opt-in に
デフォルトインストールから除外されます。1.11.x では CUGA、Code Agents、Docling ローカルパーサーが該当します。ドキュメント解析に Docling を使っていた場合はアップグレード後に動作しなくなるため、lfx-bundles[all] を別途搬入する必要があります。PyTorch は wheel 容量が大きいため、搬入計画に予め織り込んでください。
閉域網への搬入手順
インターネット区間で wheel を収集し、社内へ移してオフラインで導入します。本番と同じ Python バージョン / OS / CPU アーキテクチャで収集してください — そうしないとプラットフォームの合わない wheel を取得することになります。
# [1] 인터넷 구간 — wheel 수집 (운영과 동일한 플랫폼에서 실행)
pip download "langflow==1.11.4" -d ./lf-wheels
pip download "lfx-bundles[all]" -d ./lf-wheels   # PyTorch 계열이 필요한 경우에만

# [2] ./lf-wheels 디렉터리를 사내망으로 반입

# [3] 폐쇄망 — 외부 인덱스를 차단한 채 로컬 wheel만으로 설치
pip install --no-index --find-links=./lf-wheels "langflow==1.11.4"
사내 PyPI 미러가 있다면
매번 wheel을 손으로 옮기는 대신 pip install --index-url https://pypi.사내도메인/simple langflow==1.11.4 형태로 한 번에 해결할 수 있습니다. 5장의 pip install 절과 함께 보세요.
If you have an internal PyPI mirror
Instead of hand-carrying wheels every time, point pip at it: pip install --index-url https://pypi.your-domain/simple langflow==1.11.4. See also the pip install section in Chapter 5.
若已有内部 PyPI 镜像
无需每次手动搬运 wheel,可直接指向镜像:pip install --index-url https://pypi.内部域名/simple langflow==1.11.4。另请参阅第 5 章的 pip install 一节。
社内 PyPI ミラーがある場合
毎回 wheel を手作業で運ぶ代わりに、ミラーを指定すれば一度で済みます:pip install --index-url https://pypi.社内ドメイン/simple langflow==1.11.4。5章の pip install 節も併せてご覧ください。
12-2. 인증 기본값 변경 — 컨테이너가 안 뜨는 이유1.11
1.11은 인증 기본값을 fail-closed로 전환했습니다. 즉, 설정이 빠지면 조용히 기본값으로 넘어가는 대신 기동 자체가 실패합니다. 업그레이드 직후 "컨테이너가 계속 죽는다"의 대부분이 여기서 옵니다.
- 레거시
langflow/langflow기본 superuser 자격증명이 완전히 제거되었습니다. - 공식 Docker 이미지가
LANGFLOW_AUTO_LOGIN=false상태로 출고됩니다. LANGFLOW_SUPERUSER_PASSWORD가 필수입니다. 없으면 기본 비밀번호를 만드는 대신 기동에 실패합니다.LANGFLOW_SECRET_KEY를 더 이상 자동 생성하지 않습니다. 프로덕션에서는 직접 생성해 명시적으로 지정하세요.
12-2. Authentication Defaults Changed — Why Your Container Won't Start1.11
1.11 flipped authentication defaults to fail-closed: when configuration is missing, startup fails instead of quietly falling back to a default. Most "the container keeps dying" reports right after upgrading trace back to this.
- The legacy
langflow/langflowdefault superuser credentials are gone entirely. - Official Docker images ship with
LANGFLOW_AUTO_LOGIN=false. LANGFLOW_SUPERUSER_PASSWORDis required. Without it, startup fails rather than creating a default password.LANGFLOW_SECRET_KEYis no longer auto-generated. Generate one and set it explicitly in production.
12-2. 认证默认值变更 — 容器无法启动的原因1.11
1.11 将认证默认值改为 fail-closed:配置缺失时不再静默回退到默认值,而是直接启动失败。升级后"容器不断挂掉"的情况大多源于此。
- 旧版
langflow/langflow默认 superuser 凭据已彻底移除。 - 官方 Docker 镜像以
LANGFLOW_AUTO_LOGIN=false出厂。 LANGFLOW_SUPERUSER_PASSWORD为必填。缺失时不会创建默认密码,而是启动失败。LANGFLOW_SECRET_KEY不再自动生成。生产环境请自行生成并显式指定。
12-2. 認証デフォルトの変更 — コンテナが起動しない原因1.11
1.11 では認証のデフォルトが fail-closed に変わりました。設定が欠けている場合、黙ってデフォルトにフォールバックせず起動そのものが失敗します。アップグレード直後の「コンテナが落ち続ける」の大半はこれが原因です。
- レガシーな
langflow/langflowの既定 superuser 資格情報は完全に削除されました。 - 公式 Docker イメージは
LANGFLOW_AUTO_LOGIN=falseで出荷されます。 LANGFLOW_SUPERUSER_PASSWORDが必須です。無い場合は既定パスワードを作らず起動に失敗します。LANGFLOW_SECRET_KEYは自動生成されなくなりました。本番では自身で生成し明示的に設定してください。
services:
  langflow:
    image: langflowai/langflow:1.11.4
    environment:
      - LANGFLOW_AUTO_LOGIN=False
      - LANGFLOW_SUPERUSER=administrator
      # 값을 파일에 직접 쓰지 말고 .env 또는 시크릿 관리 도구에서 주입
      - LANGFLOW_SUPERUSER_PASSWORD=${LANGFLOW_SUPERUSER_PASSWORD}
- LANGFLOW_SECRET_KEY=${LANGFLOW_SECRET_KEY}LANGFLOW_SECRET_KEY는 아래처럼 생성합니다. 이 키가 바뀌면 기존에 저장된 Global Variable과 API Key를 복호화할 수 없으므로, 한 번 정하면 안전한 곳에 보관하고 재배포 시에도 동일한 값을 쓰세요.
Generate LANGFLOW_SECRET_KEY as below. If this key changes, previously stored Global Variables and API keys can no longer be decrypted — set it once, keep it somewhere safe, and reuse the same value across redeployments.
按如下方式生成 LANGFLOW_SECRET_KEY。该密钥一旦更改,此前保存的 Global Variable 与 API Key 将无法解密,因此确定后请妥善保管,重新部署时也使用同一值。
LANGFLOW_SECRET_KEY は以下のように生成します。このキーが変わると既存の Global Variable と API Key を復号できなくなるため、一度決めたら安全な場所に保管し、再デプロイ時も同じ値を使用してください。
python3 -c "from secrets import token_urlsafe; print(token_urlsafe(32))"12-3. 그 밖의 Breaking Change
12-3. Other Breaking Changes
- Workflow API v2 request schema changed: client code written against v2 on 1.10.x will not work unchanged. See Chapter 8.
- Input Schema pane removed: the separate Input Schema panel was absorbed into Parameters inside each component. The UI path changed, so internal training material with older screenshots needs refreshing.
- Text / JSON / Table Operations went legacy: consolidated into Data Operations. Existing flows keep working — see Chapter 3.
12-3. 其他 Breaking Change
12-3. その他の Breaking Change
12-4. 업그레이드 체크리스트
1.9 / 1.10 → 1.11 이관 시 아래 순서로 확인하세요.
- Flow 백업: 이관 전 모든 Flow를 JSON으로 Export 해 둡니다. 되돌릴 수단을 먼저 확보하세요.
- 사용 중인 컴포넌트 목록화: 어떤 서드파티 번들에 의존하는지 정리합니다. Docling 등 PyTorch 계열을 쓰는지 특히 확인.
- wheel 사전 반입: 12-1의 절차로
langflow+ 필요한 번들을 수집해 사내로 옮깁니다. - 환경변수 설정: 12-2의 4개 변수를 먼저 채웁니다. 이걸 빼면 기동 자체가 안 됩니다.
- 스테이징에서 기동 확인: 운영에 바로 올리지 말고, 컨테이너가 뜨고 로그인이 되는지부터 확인합니다.
- Flow 동작 검증: Data Operations로 통합된 컴포넌트, Knowledge의 DB Provider 설정, Agent의 Tool 연결을 차례로 점검합니다.
- API 클라이언트 점검:
/api/v1/responses를 쓰는 코드는 그대로 동작합니다. v2를 쓰던 코드만 스키마를 맞춥니다.
12-4. Upgrade Checklist
Work through these in order when moving 1.9 / 1.10 → 1.11.
- Back up flows: export every flow to JSON before you start. Secure your way back first.
- Inventory your components: note which third-party bundles you depend on. Check especially for PyTorch-based ones like Docling.
- Stage the wheels: use the 12-1 procedure to collect
langflowplus the bundles you need and move them inside. - Set environment variables: fill in the four variables from 12-2 first — without them nothing starts.
- Boot in staging: don't go straight to production; confirm the container starts and you can log in.
- Verify flows: check the components folded into Data Operations, the Knowledge DB Provider setting, and Agent tool connections in turn.
- Check API clients: code using
/api/v1/responseskeeps working. Only v2 callers need schema updates.
12-4. 升级检查清单
从 1.9 / 1.10 → 1.11 迁移时,请按以下顺序确认。
- 备份 Flow:迁移前将所有 Flow 导出为 JSON。先确保有回退手段。
- 梳理所用组件:整理依赖了哪些第三方捆绑包,特别确认是否使用 Docling 等 PyTorch 系组件。
- 预先导入 wheel:按 12-1 的流程收集
langflow及所需捆绑包并转入内网。 - 配置环境变量:先填好 12-2 的四个变量,缺失则根本无法启动。
- 在预发布环境启动验证:不要直接上生产,先确认容器能启动且可以登录。
- 验证 Flow 运行:依次检查并入 Data Operations 的组件、Knowledge 的 DB Provider 设置以及 Agent 的 Tool 连接。
- 检查 API 客户端:使用
/api/v1/responses的代码可照常运行,仅使用 v2 的代码需调整结构。
12-4. アップグレードチェックリスト
1.9 / 1.10 → 1.11 への移行時は以下の順に確認してください。
- Flow のバックアップ:移行前に全 Flow を JSON でエクスポート。まず戻れる手段を確保します。
- 使用コンポーネントの棚卸し:どのサードパーティバンドルに依存しているか整理。Docling など PyTorch 系の使用有無を特に確認。
- wheel の事前搬入:12-1 の手順で
langflowと必要なバンドルを収集し社内へ移します。 - 環境変数の設定:12-2 の4変数を先に埋めます。これが無いと起動しません。
- ステージングで起動確認:いきなり本番に上げず、コンテナが起動しログインできるかから確認します。
- Flow の動作検証:Data Operations に統合されたコンポーネント、Knowledge の DB Provider 設定、Agent の Tool 接続を順に点検します。
- API クライアントの点検:
/api/v1/responsesを使うコードはそのまま動作します。v2 を使うコードのみスキーマを合わせます。
13. 하네스 엔지니어링 (Harness Engineering)
"모델이 아니라 환경이 병목이다" — 하네스 엔지니어링은 AI 에이전트가 안정적으로 작업할 수 있도록 제약, 피드백, 운영 시스템을 설계하는 방법론입니다. 2026년 2월 HashiCorp과 OpenAI에 의해 공식화되었습니다.
비유로 이해하기
말(Horse)은 아무리 빠르고 강해도, 마구(Harness)와 마차(Cart)가 없으면 짐을 나를 수 없습니다. LLM 모델은 말이고, 하네스 엔지니어링은 그 마구를 설계하는 일입니다. 고삐(제약), 안장(컨텍스트), 채찍(피드백), 수레(운영 시스템) 모두가 갖춰져야 실제 업무에 투입할 수 있습니다.
무엇을 물어볼까?What to ask?问什么?何を聞くか?
무엇을 보여줄까?What to show?给什么?何を見せるか?
환경을 어떻게?How to design env?环境怎么设计?環境をどう設計するか?
프롬프트 < 컨텍스트 < 하네스
AI 활용 패러다임은 세 단계로 진화하고 있습니다:
1단계: Prompt Engineering — "무엇을 물어볼까?" 단일 입력-출력 쌍 안에서 지시문을 최적화합니다. "You are an expert X. Do Y like Z" 형태의 일회성 기법입니다.
2단계: Context Engineering — "무엇을 보여줄까?" LLM이 작업을 완수하는 데 필요한 모든 정보를 동적으로 조립하는 체계적 설계입니다. Context Window 안에 시스템 프롬프트 + 대화 히스토리 + 검색 문서 + 현재 입력 + 출력 예약분을 어떻게 배분할지가 핵심입니다.
Lost in the Middle 현상
관련 정보가 Context의 중간에 위치하면 성능이 최대 20% 이상 하락합니다 (Liu et al., 2023). 시작 부분 85-90%, 중간 부분 65-70%, 끝 부분 80-85% 정확도로, 정보의 위치가 정확도를 결정합니다. 단순히 정보를 많이 넣는 것이 아니라, 어디에 배치하느냐가 핵심입니다.
3단계: Harness Engineering — "환경을 어떻게 설계할까?" 프롬프트와 컨텍스트를 넘어, 제약·피드백 루프·운영 시스템 전체를 설계합니다. 모델 성능은 빠르게 평준화되지만, 하네스는 팀이 직접 쌓아야 하는 차별화 자산입니다.
13. Harness Engineering
"The bottleneck is the environment, not the model" — Harness Engineering is the methodology of designing constraints, feedback loops, and operational systems so AI agents can work reliably. Formalized in Feb 2026 by HashiCorp and OpenAI.
Analogy
A horse, however fast and strong, cannot carry cargo without a harness and cart. The LLM is the horse; harness engineering is designing the harness — reins (constraints), saddle (context), whip (feedback), carriage (ops system). All pieces must be in place for real-world work.
Prompt < Context < Harness
AI utilization has evolved through three paradigms:
Stage 1: Prompt Engineering — "What to ask?" Optimize instructions within a single input-output pair.
Stage 2: Context Engineering — "What to show?" Systematically assemble all information the LLM needs: system prompt + conversation history + retrieved docs + current input + reserved output. The "Lost in the Middle" phenomenon (Liu et al., 2023) shows up to 20% accuracy drop when relevant info sits in the middle of the context.
Stage 3: Harness Engineering — "How to design the environment?" Beyond prompts and context, design constraints, feedback loops, and operational systems as a whole. Model performance is rapidly commoditizing; the harness is the differentiating asset teams must build.
13. 哈尼斯工程(Harness Engineering)
"瓶颈在于环境,而非模型" — 哈尼斯工程是设计约束、反馈循环和运营系统以使AI Agent可靠工作的方法论。2026年2月由HashiCorp和OpenAI正式提出。
Prompt < Context < Harness
第1阶段:Prompt Engineering — "问什么?" 在单次输入输出中优化指令。
第2阶段:Context Engineering — "展示什么?" 系统性地动态组装所有信息。"Lost in the Middle"现象显示相关信息在上下文中间时准确率下降高达20%。
第3阶段:Harness Engineering — "如何设计环境?" 超越 Prompt 和 Context,设计约束 + 反馈循环 + 运营系统。模型性能快速同质化,Harness 才是团队的差异化资产。
13. ハーネスエンジニアリング
「ボトルネックはモデルではなく環境にある」 — ハーネスエンジニアリングは、AIエージェントが安定的に動作できるよう制約、フィードバック、運用システムを設計する方法論です。2026年2月にHashiCorpとOpenAIにより公式化されました。
Prompt < Context < Harness
第1段階:Prompt Engineering — 「何を聞くか?」単一の入出力ペアで指示を最適化。
第2段階:Context Engineering — 「何を見せるか?」LLMに必要なすべての情報を体系的に動的組立。「Lost in the Middle」現象では、関連情報がContext中央にあると精度が最大20%低下します。
第3段階:Harness Engineering — 「環境をどう設計するか?」PromptとContextを超え、制約+フィードバック+運用システム全体を設計。モデル性能がコモディティ化する中、ハーネスこそチームの差別化資産です。
| 개념 | Concept | 概念 | 概念 | 핵심 질문 | Key Question | 核心问题 | 核心質問 | 설계 대상 | Design Target | 设计对象 | 設計対象 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Prompt Engineering | Prompt Engineering | Prompt Engineering | Prompt Engineering | 무엇을 물어볼까? | What to ask? | 问什么? | 何を聞くか? | LLM 지시문 | LLM instructions | LLM 指令 | LLM指示文 |
| Context Engineering | Context Engineering | Context Engineering | Context Engineering | 무엇을 보여줄까? | What to show? | 展示什么? | 何を見せるか? | 추론 시점의 모든 토큰 | All tokens at inference | 推理时的所有Token | 推論時の全トークン |
| Harness Engineering | Harness Engineering | Harness Engineering | Harness Engineering | 환경을 어떻게 설계할까? | How to design the env? | 如何设计环境? | 環境をどう設計するか? | 제약 + 피드백 + 운영 시스템 | Constraints + feedback + ops | 约束 + 反馈 + 运营系统 | 制約 + フィードバック + 運用 |
하네스의 6가지 구성 요소
1. 컨텍스트 파일
프로젝트 지시 문서 (CLAUDE.md, AGENTS.md 등). 코딩 규칙, 아키텍처, 빌드 명령을 명시합니다. 목차(Map) 형태로 모듈식 구성이 효과적입니다.
2. MCP 서버
외부 도구·데이터 연결. 이슈 트래커, 사내 문서 검색, DB 등을 연결하되, 필요한 것만 선별적으로 연결합니다.
3. 스킬 파일
반복 작업 절차를 SKILL.md에 문서화. 코드 리뷰 체크리스트, 배포 워크플로 등 에이전트가 참조/수행합니다.
4. 기계적 강제
커스텀 린터로 아키텍처 규칙을 자동 검증. 린터 실패 시 "어떻게 수정할지"를 컨텍스트에 주입합니다.
5. 가비지 컬렉션
백그라운드 에이전트가 코드·문서 편차를 지속 스캔. 낡은 패턴을 자동 리팩토링 PR로 생성합니다.
6. 관찰 가능성
로그, 메트릭, 실행 추적 접근 권한을 에이전트에 제공. 에이전트가 스스로 디버깅·검증 가능하게 합니다.
Langflow에서의 하네스 엔지니어링
Langflow의 Flow 자체가 하네스의 일부입니다. Flow를 설계할 때 하네스 관점을 적용하면 안정성과 재현성이 크게 향상됩니다:
- Prompt Template = 컨텍스트 파일 역할 (일관된 지시사항)
- Tool Mode = MCP 서버 역할 (외부 도구 연결)
- Freeze = 검증된 결과 캐싱 (불필요한 API 호출 방지)
- Traces (1.8+) = 관찰 가능성 (실행 과정 추적)
- Dev → Prod 프로모션 = 피드백 루프 (검증 후 배포)
핵심 인사이트
모델 성능은 빠르게 평준화됩니다. 하네스는 팀이 직접 쌓아야 하는 차별화 자산입니다. OpenAI Codex 실험에서 5개월 간 수동 코드 0줄로 백만 라인을 생성한 것은, 모델이 아닌 하네스 개선의 결과입니다.
6 Components of a Harness
1. Context Files
Project instruction docs (CLAUDE.md, AGENTS.md). Specify coding rules, architecture, build commands. Modular map-style structure is most effective.
2. MCP Servers
External tool/data connections. Issue trackers, internal docs, DBs — connect only what's needed selectively.
3. Skill Files
Documented procedures in SKILL.md. Code review checklists, deployment workflows for the agent to reference.
4. Mechanical Enforcement
Custom linters auto-verify architecture rules. On failure, inject "how to fix" into the context.
5. Garbage Collection
Background agents scan for code/doc drift. Auto-generate refactoring PRs for outdated patterns.
6. Observability
Give agents access to logs, metrics, execution traces. Enables self-debugging and verification.
Harness Engineering in Langflow
Langflow Flows are themselves part of the harness. Applying harness thinking to Flow design greatly improves stability and reproducibility:
- Prompt Template = Context files (consistent instructions)
- Tool Mode = MCP servers (external tool connection)
- Freeze = Caching verified results (prevent unnecessary API calls)
- Traces (1.8+) = Observability (execution tracking)
- Dev → Prod promotion = Feedback loop (validate before deploy)
Key Insight
Model performance is rapidly commoditizing. The harness is the differentiating asset teams must build themselves. In OpenAI's Codex experiment, generating 1M lines with 0 manual code over 5 months was the result of harness improvements, not model changes.
哈尼斯的 6 个组成部分
1. 上下文文件
项目指令文档。指定编码规则、架构、构建命令。模块化目录结构最有效。
2. MCP 服务器
外部工具/数据连接。仅选择性连接必要的系统。
3. 技能文件
在 SKILL.md 中文档化的重复任务流程。
4. 机械强制
自定义 Linter 自动验证架构规则。
5. 垃圾回收
后台 Agent 持续扫描代码/文档偏差,自动生成重构 PR。
6. 可观测性
为 Agent 提供日志、指标、执行追踪访问权限。
Langflow 中的哈尼斯工程
- Prompt Template = 上下文文件
- Tool Mode = MCP 服务器
- Freeze = 缓存已验证的结果
- Traces = 可观测性
- Dev → Prod = 反馈循环
核心洞察
模型性能正在快速平等化。哈尼斯是团队必须自建的差异化资产。
ハーネスの6つの構成要素
1. コンテキストファイル
プロジェクト指示文書。コーディング規則、アーキテクチャ、ビルドコマンドを明記。モジュール式マップ構造が効果的です。
2. MCPサーバー
外部ツール・データ接続。必要なものだけ選択的に接続します。
3. スキルファイル
SKILL.mdに反復作業手順を文書化。コードレビューチェックリスト等。
4. 機械的強制
カスタムリンターでアーキテクチャルールを自動検証。
5. ガベージコレクション
バックグラウンドエージェントがコード・文書の乖離を継続スキャン。
6. 観測可能性
ログ、メトリクス、実行トレースへのアクセスをエージェントに提供。
Langflowでのハーネスエンジニアリング
- Prompt Template = コンテキストファイル
- Tool Mode = MCPサーバー
- Freeze = 検証済み結果のキャッシュ
- Traces = 観測可能性
- Dev → Prod = フィードバックループ
核心インサイト
モデル性能は急速にコモディティ化しています。ハーネスはチームが自ら構築すべき差別化資産です。
퀴즈
Quiz
测验
クイズ
Prompt Engineering, Context Engineering, Harness Engineering의 핵심 차이점은 무엇인가요?
What is the key difference between Prompt Engineering, Context Engineering, and Harness Engineering?
Prompt Engineering、Context Engineering 和 Harness Engineering 的核心区别是什么?
Prompt Engineering、Context Engineering、Harness Engineering の核心的な違いは何ですか?
정답 보기
Show Answer
查看答案
答えを見る
Prompt Engineering은 "무엇을 물어볼까"(지시문 설계), Context Engineering은 "무엇을 보여줄까"(추론 시점에 제공할 모든 토큰), Harness Engineering은 "환경을 어떻게 설계할까"(제약 + 피드백 루프 + 운영 시스템)입니다. 모델 성능이 평준화되면서, 차별화의 핵심은 프롬프트가 아니라 하네스(환경 설계)로 이동하고 있습니다.
Prompt Engineering = "What to ask" (instruction design). Context Engineering = "What to show" (all tokens at inference). Harness Engineering = "How to design the environment" (constraints + feedback loops + ops systems). As model performance commoditizes, differentiation is shifting from prompts to harness design.
Prompt Engineering = "问什么"(指令设计)。Context Engineering = "展示什么"(推理时提供的所有 Token)。Harness Engineering = "如何设计环境"(约束 + 反馈循环 + 运营系统)。随着模型性能同质化,差异化的核心正从 Prompt 转向Harness 设计。
Prompt Engineering = 「何を聞くか」(指示文設計)。Context Engineering = 「何を見せるか」(推論時の全トークン)。Harness Engineering = 「環境をどう設計するか」(制約 + フィードバック + 運用システム)。モデル性能がコモディティ化する中、差別化の核心はプロンプトからハーネス設計へ移行しています。
Langflow 내부 아키텍처 (개발자용)
Langflow를 단순 사용이 아닌 개발·운영 관점에서 이해하기 위한 아키텍처 요약입니다. DeepWiki 분석을 기반으로 합니다.
3-Tier 풀스택 구조
Frontend
React 19 SPA (TypeScript + Vite). @xyflow/react로 비주얼 Flow 캔버스를 렌더링합니다. 상태 관리는 Zustand, 서버 상태 동기화는 React Query를 사용합니다.
Backend
FastAPI 서버. 서비스 지향 패턴으로 Settings → Database → Auth → Task 순으로 초기화됩니다. API는 /api/v1/ 아래 flows, build, components, chat 등의 라우트로 구성됩니다.
Execution Engine (LFX)
lfx 패키지가 그래프 실행을 담당합니다. Flow JSON → DAG 토폴로지 정렬 → Vertex별 컴포넌트 빌드/실행 → 결과 전파의 파이프라인으로 동작합니다.
패키지 구조
Langflow Internal Architecture (For Developers)
An architecture summary for understanding Langflow from a development and operations perspective, based on DeepWiki analysis.
3-Tier Full-Stack Architecture
Frontend
React 19 SPA (TypeScript + Vite). Visual flow canvas rendered with @xyflow/react. State management via Zustand, server state sync via React Query.
Backend
FastAPI server. Service-oriented initialization: Settings → Database → Auth → Task. API routes under /api/v1/ for flows, build, components, chat.
Execution Engine (LFX)
lfx package handles graph execution. Pipeline: Flow JSON → DAG topological sort → per-Vertex component build/execute → output propagation.
Package Structure
Langflow 内部架构(开发者用)
从开发和运维角度理解 Langflow 的架构摘要,基于 DeepWiki 分析。
三层全栈架构
Frontend
React 19 SPA(TypeScript + Vite)。使用 @xyflow/react 渲染可视化 Flow 画布。状态管理用 Zustand,服务端状态同步用 React Query。
Backend
FastAPI 服务器。面向服务的初始化:Settings → Database → Auth → Task。API 路由位于 /api/v1/ 下。
执行引擎(LFX)
lfx 包负责图执行。流程:Flow JSON → DAG 拓扑排序 → 逐 Vertex 构建/执行 → 输出传播。
包结构
Langflow 内部アーキテクチャ(開発者向け)
Langflow を開発・運用の観点から理解するためのアーキテクチャ要約です。DeepWiki 分析に基づいています。
3層フルスタック構成
Frontend
React 19 SPA(TypeScript + Vite)。@xyflow/react でビジュアル Flow キャンバスをレンダリング。状態管理は Zustand、サーバー状態同期は React Query。
Backend
FastAPI サーバー。サービス指向パターンで Settings → Database → Auth → Task の順に初期化。API ルートは /api/v1/ 配下。
実行エンジン(LFX)
lfx パッケージがグラフ実行を担当。Flow JSON → DAG トポロジカルソート → Vertex ごとのコンポーネントビルド/実行 → 出力伝播。
パッケージ構成
| 패키지 | Package | 包 | パッケージ | Version | 역할 | Role | 角色 | 役割 |
|---|---|---|---|---|---|---|---|---|
langflow | 1.9.0 | CLI + 전체 번들 | CLI + full bundle | CLI + 完整捆绑 | CLI + フルバンドル | |||
langflow-base | 0.9.0 | 백엔드 코어 | Backend core | 后端核心 | バックエンドコア | |||
lfx | 0.4.0 | 실행 엔진 | Execution engine | 执行引擎 | 実行エンジン | |||
langflow-sdk | 0.1.0 | 프로그래밍 클라이언트 | Programmatic client | 编程客户端 | プログラマティッククライアント |
백엔드 서비스 구조
Backend Service Architecture
后端服务架构
バックエンドサービス構成
| 서비스 | Service | 服务 | サービス | 역할 | Purpose | 用途 | 目的 | 기술 | Tech | 技术 | 技術 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| SettingsService | 설정 관리 | Configuration | 配置管理 | 設定管理 | dynaconf + env vars | ||||||
| DatabaseService | ORM, 마이그레이션 | ORM, migrations | ORM, 迁移 | ORM, マイグレーション | SQLModel, Alembic | ||||||
| AuthService | JWT + OAuth2 인증 | JWT + OAuth2 auth | JWT + OAuth2 认证 | JWT + OAuth2認証 | bcrypt, RBAC | ||||||
| TaskService | 비동기 작업 실행 | Async task execution | 异步任务执行 | 非同期タスク実行 | AnyIO / Celery | ||||||
| MCPService | MCP 프로토콜 관리 | MCP orchestration | MCP 协议管理 | MCPプロトコル管理 | MCP Server |
데이터베이스 & 배포
- DB 지원: SQLite (개발), PostgreSQL v15+ (프로덕션), Couchbase/ClickHouse (옵션)
- 마이그레이션: Alembic 기반 스키마 버저닝 (
langflow/alembic/) - 캐싱: DiskCache 또는 Redis로 Flow 실행 결과 캐싱, 컴포넌트 인덱스 캐싱으로 시작 시간 단축
배포 옵션
Desktop App
Electron 래퍼 + 내장 Python. macOS 13+, Windows 11+ 지원.
Python Package
uv pip install langflow. Python 3.10~3.13 지원.
Docker
docker run -p 7860:7860 langflowai/langflow
Source Build
make init && make run_cli로 개발 모드 실행.
개발자를 위한 주요 환경변수
Database & Deployment
- DB Support: SQLite (dev), PostgreSQL v15+ (production), Couchbase/ClickHouse (optional)
- Migrations: Alembic-based schema versioning (
langflow/alembic/) - Caching: DiskCache or Redis for flow results, component index caching for faster startup
Deployment Options
Desktop App
Electron wrapper + embedded Python. macOS 13+, Windows 11+.
Python Package
uv pip install langflow. Python 3.10-3.13.
Docker
docker run -p 7860:7860 langflowai/langflow
Source Build
make init && make run_cli for dev mode.
Key Environment Variables for Developers
数据库与部署
- DB 支持:SQLite(开发)、PostgreSQL v15+(生产)、Couchbase/ClickHouse(可选)
- 迁移:基于 Alembic 的 schema 版本管理
- 缓存:DiskCache 或 Redis 缓存 Flow 结果,组件索引缓存加速启动
部署选项
桌面应用
Electron + 内嵌 Python。macOS 13+、Windows 11+。
Python 包
uv pip install langflow。Python 3.10-3.13。
Docker
docker run -p 7860:7860 langflowai/langflow
源码构建
make init && make run_cli 开发模式运行。
开发者关键环境变量
データベース & デプロイ
- DB サポート:SQLite(開発)、PostgreSQL v15+(本番)、Couchbase/ClickHouse(オプション)
- マイグレーション:Alembic ベースのスキーマバージョニング
- キャッシュ:DiskCache または Redis で Flow 実行結果をキャッシュ、コンポーネントインデックスキャッシュで起動時間短縮
デプロイオプション
Desktop App
Electron ラッパー + 内蔵 Python。macOS 13+、Windows 11+。
Python パッケージ
uv pip install langflow。Python 3.10〜3.13。
Docker
docker run -p 7860:7860 langflowai/langflow
ソースビルド
make init && make run_cli で開発モード実行。
開発者向け主要環境変数
| 환경변수 | Env Variable | 环境变量 | 環境変数 | 설명 | Description | 说明 | 説明 |
|---|---|---|---|---|---|---|---|
LANGFLOW_DATABASE_URL | DB 연결 문자열 (SQLite/PostgreSQL) | DB connection string | 数据库连接字符串 | DB接続文字列 | |||
LANGFLOW_ALLOW_CUSTOM_COMPONENTS | Custom Component 코드 편집 허용 여부 | Enable/disable code editing | 是否允许自定义组件代码编辑 | Custom Componentコード編集の許可 | |||
LANGFLOW_WORKERS | Uvicorn 워커 수 (기본 1, 권장 3+) | Uvicorn workers (default 1, recommend 3+) | Uvicorn Worker 数(默认 1,推荐 3+) | Uvicornワーカー数(デフォルト1、推奨3+) | |||
LANGFLOW_SECRET_KEY | Credential 암호화용 Fernet 키 | Fernet key for Credential encryption | Credential 加密用 Fernet 密钥 | Credential暗号化用Fernetキー | |||
LANGFLOW_API_KEY_SOURCE | API Key 소스 (env로 설정 시 OS 환경변수에서 읽음) | API Key source (env = read from OS env) | API Key 来源(env = 从系统环境变量读取) | API Keyソース(env=OS環境変数から読み込み) | |||
LFX_DEV=1 | 개발 모드 — 동적 컴포넌트 로딩 활성화 | Dev mode — dynamic component loading | 开发模式——动态组件加载 | 開発モード——動的コンポーネントロード |
Source: DeepWiki — langflow-ai/langflow
참고자료
공식 문서
- Langflow 공식 문서 — 컴포넌트, API, 설치 가이드
- Langflow GitHub 저장소 — 소스 코드, 이슈, 릴리스 노트
- Langflow 릴리스 노트 — 버전별 신기능과 breaking change 원본
- Langflow 1.11 릴리스 발표 — HITL, A2A, Workflow API v2
- Langflow 1.10 릴리스 발표 — Memory Bases, DB Providers, 다국어
LLM 추론 엔진
- vLLM 공식 문서 — 설치, 모델 서빙, OpenAI-compatible API
- vLLM 논문 — Woosuk Kwon et al., "Efficient Memory Management for Large Language Model Serving with PagedAttention" (2023)
AI 기초 논문 & 아티클
- Attention Is All You Need — Vaswani et al. (2017), Transformer 아키텍처 원 논문
- Context Engineering: AI 시대의 새로운 핵심 역량 — SK Devocean, Prompt → Context Engineering 진화 분석
- Jensen Huang on Compute as a New Economic Engine — Morgan Stanley, Tokenomics와 AI Factory 비전
오픈소스 모델
- Qwen (Alibaba) — Qwen3.8 시리즈(Max / 27B), 다국어·멀티모달
- GLM (Zhipu AI) — GLM-5.2 / 5.3, MoE 아키텍처
- Kimi (Moonshot AI) — Kimi K3, 긴 컨텍스트(1M)
- Llama (Meta) — Llama 4 시리즈, 오픈소스 LLM
본 가이드
- langflow-guide GitHub — 본 가이드 소스 코드
- Issues — 내용 추가/수정 요청
References
Official Documentation
- Langflow Official Docs — Components, API, installation guide
- Langflow GitHub Repository — Source code, issues, release notes
- Langflow Release Notes — the source of truth for new features and breaking changes
- Langflow 1.11 announcement — HITL, A2A, Workflow API v2
- Langflow 1.10 announcement — Memory Bases, DB Providers, i18n
LLM Inference Engine
- vLLM Official Docs — Installation, model serving, OpenAI-compatible API
- vLLM Paper — Woosuk Kwon et al., "Efficient Memory Management for Large Language Model Serving with PagedAttention" (2023)
AI Foundation Papers & Articles
- Attention Is All You Need — Vaswani et al. (2017), original Transformer paper
- Context Engineering: A New Core Competency for the AI Era — SK Devocean, Prompt → Context Engineering evolution
- Jensen Huang on Compute as a New Economic Engine — Morgan Stanley, Tokenomics and AI Factory vision
Open Source Models
- Qwen (Alibaba) — Qwen3.8 series (Max / 27B), multilingual and multimodal
- GLM (Zhipu AI) — GLM-5.2 / 5.3, MoE architecture
- Kimi (Moonshot AI) — Kimi K3, long context (1M)
- Llama (Meta) — Llama 4 series, open-source LLM
This Guide
- langflow-guide GitHub — Source code for this guide
- Issues — Request content additions/changes
参考资料
官方文档
- Langflow 官方文档 — 组件、API、安装指南
- Langflow GitHub 仓库 — 源码、Issues、发布说明
- Langflow 发布说明 — 各版本新功能与 breaking change 的原始出处
- Langflow 1.11 发布公告 — HITL、A2A、Workflow API v2
- Langflow 1.10 发布公告 — Memory Bases、DB Providers、多语言
LLM 推理引擎
AI 基础论文与文章
- Attention Is All You Need — Vaswani 等(2017),Transformer 原始论文
- Context Engineering:AI 时代的新核心能力 — SK Devocean
- Jensen Huang on Compute as a New Economic Engine — Morgan Stanley, Tokenomics
开源模型
- Qwen(阿里巴巴) — Qwen3.8 系列
- GLM(智谱 AI) — GLM-5.2 / 5.3
- Kimi(月之暗面) — Kimi K3 系列
- Llama(Meta) — Llama 4 系列
本指南
- langflow-guide GitHub — 本指南源码
- Issues — 请求添加/修改内容
参考資料
公式ドキュメント
- Langflow 公式ドキュメント — コンポーネント、API、インストールガイド
- Langflow GitHub リポジトリ — ソースコード、Issues、リリースノート
- Langflow リリースノート — バージョンごとの新機能と breaking change の原典
- Langflow 1.11 リリース発表 — HITL、A2A、Workflow API v2
- Langflow 1.10 リリース発表 — Memory Bases、DB Providers、多言語対応
LLM 推論エンジン
- vLLM 公式ドキュメント — インストール、モデルサービング、OpenAI-compatible API
- vLLM 論文 — Woosuk Kwon ら、PagedAttention(2023)
AI 基礎論文・記事
- Attention Is All You Need — Vaswani ら(2017)、Transformer 原論文
- Context Engineering:AI時代の新たなコア能力 — SK Devocean
- Jensen Huang on Compute as a New Economic Engine — Morgan Stanley, Tokenomics
オープンソースモデル
- Qwen(Alibaba) — Qwen3.8 シリーズ
- GLM(Zhipu AI) — GLM-5 シリーズ
- Kimi(Moonshot AI) — Kimi K3 シリーズ
- Llama(Meta) — Llama 4 シリーズ
本ガイド
- langflow-guide GitHub — 本ガイドのソースコード
- Issues — コンテンツの追加・修正リクエスト